OpenRouter와 TypeSafe Jev로 LLM 요청 자동 분류 및 파이프라인 비용 최적화하기
OpenRouter의 Classifiers 기능을 활용해 TypeSafe AI의 빠른 System One 모델 Jev로 LLM 요청을 자동 분류하고 Explore에서 분석해 추론 비용을 대폭 절감하는 실전 팁을 정리합니다.
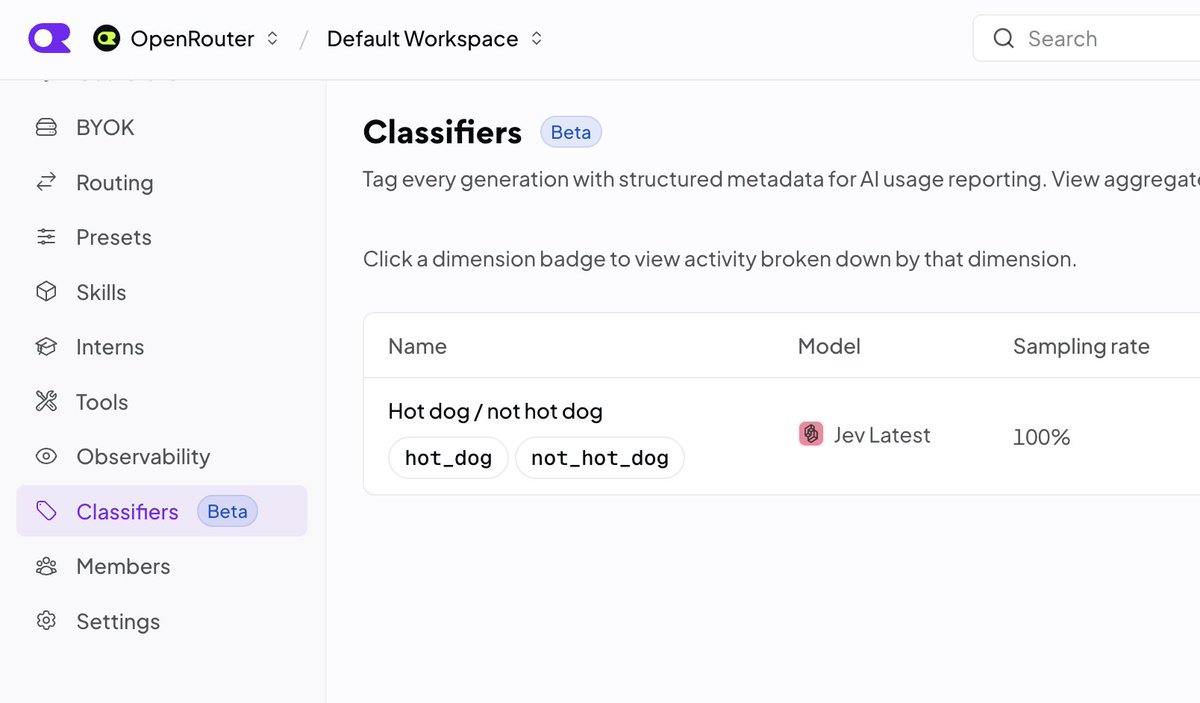
AI 게이트웨이 플랫폼 오픈라우터(OpenRouter, @OpenRouter)가 워크스페이스의 분류기(Classifiers) 설정에서 타입세이프 AI(TypeSafe AI)의 초고속 시스템 원(System One) 모델 'Jev(Jev Latest)'를 활용해 수신되는 LLM 요청을 자동 분류하고, 액티비티 익스플로어(Activity Explore) 대시보드에서 태스크 믹스를 분석할 수 있는 실전 팁을 공유했습니다.
이미지 출처: OpenRouter on X
대규모 LLM 파이프라인을 운영할 때 모든 사용자 입력이나 에이전트 프롬프트를 고비용의 주력 추론 모델로 직행시키면 인프라 비용이 급격히 증가합니다. 오픈라우터가 공식 지원하는 Classifiers 기능과 경량 의사결정 모델 Jev를 결합하면, 요청이 생성 모델에 전달되기 전 단계에서 태스크의 성격을 실시간으로 판별하고 라우팅 전략을 수립할 수 있습니다.
Classifiers 설정과 Jev 기반 자동 태깅의 동작 원리
오픈라우터 워크스페이스의 Classifiers 메뉴(https://openrouter.ai/workspaces/default/classifiers)에서는 들어오는 API 호출에 대해 커스텀 분류 규칙을 활성화할 수 있습니다.
여기서 핵심 엔진으로 활용되는 TypeSafe AI의 Jev는 텍스트를 순차적으로 생성하는 일반적인 대화형 LLM과 구조적으로 다른 '시스템 원(System One)' 의사결정 모델입니다.
- 비자기회귀적 병렬 확률 평가: 일반 LLM처럼 토큰을 한 글자씩 오토리그레시브하게 생성하지 않고, 사전에 정의된 선택지나 질문에 대해 모든 확률을 병렬로 직접 계산합니다.
- 환각(Hallucination) 원천 차단: 임의의 문자열 생성을 의도적으로 배제하고 구조화된 판단 결과만을 출력하도록 설계되어, 텍스트 생성 과정에서 발생하는 환각 문제가 발생하지 않습니다.
- 초저지연·초저비용: TypeSafe AI의 발표 및 벤치마크에 따르면 기존 범용 LLM 대비 최대 수십~수백 배 빠른 추론 속도와 대폭 저렴한 호출 단가를 제공하여, 매 요청마다 사전 분류기를 거치더라도 전체 파이프라인 지연 시간을 거의 늘리지 않습니다.
이렇게 분류된 결과는 오픈라우터의 액티비티 익스플로어(https://openrouter.ai/activity/explore)에 자동 집계되어, 전체 트래픽 중 어떤 유형의 작업이 얼마나 발생하는지 시각화된 차트로 즉시 파악할 수 있습니다.
'선 분류, 후 생성' 라우팅 아키텍처와 비용 절감 패턴
현장 엔지니어들은 이 기능을 활용한 '선 분류, 후 생성(Classify first, generate second)' 아키텍처의 효용성에 주목하고 있습니다.
프로덕션 시스템에서 Jev를 운용해온 개발자 Alex Builds(@wandeforer)는 레딧(Reddit) 스레드 처리 파이프라인에서 AI 인용 여부나 답변 가치 유무를 Jev로 사전 분류한 뒤 실제 텍스트 생성 여부를 결정하는 방식을 적용해 전체 파이프라인 비용을 약 30배(30x) 절감한 사례를 공유했습니다. 게이트웨이 계층에 이러한 분류 기능이 직접 내장됨으로써 별도의 서브시스템 구축 없이도 유사한 비용 절감 파이프라인을 구성할 수 있게 되었습니다.
엔지니어 Yi Casillas(@YiCasillas) 역시 요청을 먼저 분류한 뒤 작업 난이도에 따라 서로 다른 티어의 모델로 분기하는 라우팅 방식이 실무에서 단순 잡무 처리 비용을 극적으로 낮추는 필수 패턴임을 강조했습니다. 복잡한 추론이 필요한 질의는 주력 플래그십 모델로 전달하고, 단순 사실 확인이나 포맷 변환 작업은 경량 소형 모델로 우회시킴으로써 평균 토큰 단가를 최소화할 수 있습니다.
실전 운영 시 필수 점검: 컨텍스트 누락과 경계 샘플 검증
오픈라우터의 Classifiers 기능을 프로덕션에 도입할 때는 엔지니어링 피드백에서 지적된 두 가지 주의점을 사전에 점검해야 합니다.
첫째, 분류기 컨텍스트 크기 부족으로 인한 태깅 누락 문제입니다. 엔지니어 John Rood(@johnroodepic)가 지적했듯, 분류기에 할당된 컨텍스트 윈도우가 프롬프트 전체 길이에 비해 너무 작으면 오픈라우터는 하류 모델의 텍스트 생성 자체는 정상 반환하지만 해당 요청을 태그가 없는 '언태그(untagged)' 상태로 남겨둘 수 있습니다. 따라서 익스플로어의 태스크 믹스 통계를 신뢰하기 전에 프롬프트 길이별 태그 커버리지를 반드시 교차 검증해야 합니다.
둘째, 거시적 평균치 함정과 경계 샘플(Boundary samples) 모니터링입니다. 엔지니어 Yi Casillas가 지적했듯 대시보드의 평균 지표에만 매몰되면 분류 오판이나 임계값 경계에 걸친 샘플들을 놓치기 쉽습니다. 그는 Explore 대시보드에서도 단순 평균 통계뿐 아니라 분류 오판과 경계 샘플을 직접 파악할 수 있어야 한다고 제언했습니다. 민감한 작업이나 엄격한 지침이 필요한 프롬프트가 저가형 모델로 잘못 라우팅되지 않도록, 팀 차원에서 오분류 케이스와 로그를 지속적으로 검증해야 합니다.