오픈AI, GPT-6 제품군 모델 선택 및 비용·지연 시간 최적화 공식 실전 가이드 공개
OpenAI가 GPT-6 Astra, Sol, Luna 모델 라인업의 역할 분담, 추론 수준(reasoning effort) 조절, 최대 95% 캐시 할인, 컨텍스트 압축 및 장기 작업 오케스트레이션 노하우를 담은 공식 실전 가이드를 공개했습니다.
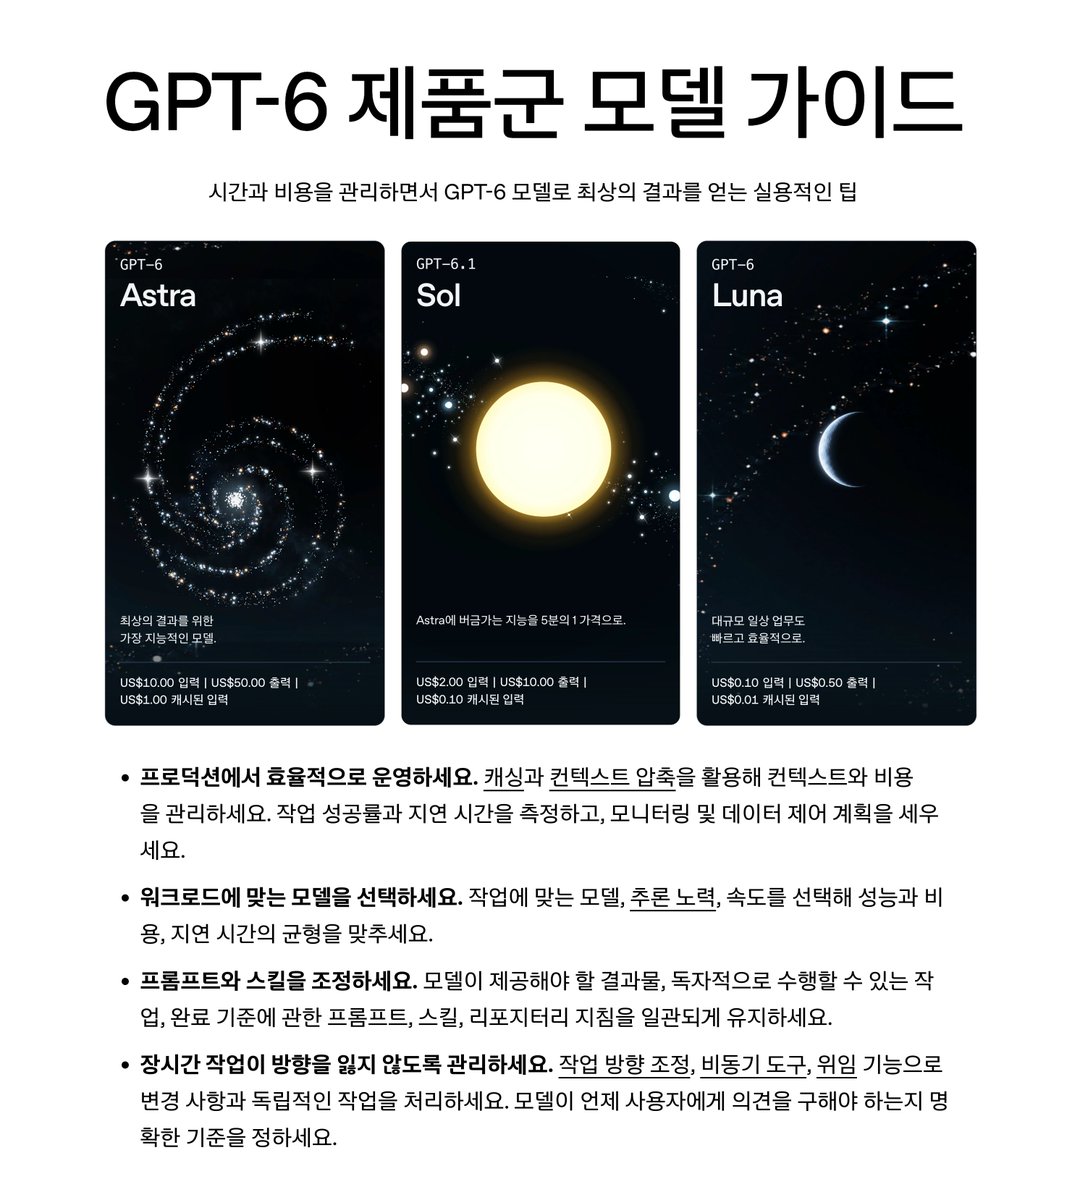
OpenAI가 2026년 10월 2일(현지시간), 최신 파운데이션 모델 라인업을 프로덕션 환경에 최적화하여 도입할 수 있도록 돕는 공식 실전 가이드 'GPT-6 제품군 모델 가이드(A model guide for the GPT-6 family)'를 전격 공개했습니다. 이번 가이드는 스타트업과 엔터프라이즈 엔지니어링 팀이 모델의 성능을 극대화하면서도 API 비용과 추론 지연 시간(latency)을 통제할 수 있는 구체적인 가이드라인을 제공합니다.
이미지 출처: OpenAI / @lucas_flatwhite (X)
이번에 공개된 엔지니어링 플레이북은 최고난도 추론을 담당하는 Astra부터 실무 워크플로우에 맞춘 Sol, 대규모 반복 처리를 위한 Luna까지 모델 라인업의 명확한 역할 분담 기준을 제시합니다. 아울러 입력 프롬프트 캐싱을 통한 최대 95% 비용 절감 기법, 세션 내 추론 강도 변경 시 캐시를 보존하는 configuration_update API, 토큰 생성 지연 시간 단축 경험칙, 그리고 며칠씩 이어지는 장기 에이전트 작업을 위한 컨텍스트 압축(Compaction) 기법을 포괄하고 있습니다.
Astra·Sol·Luna 3대 모델 역할 분담과 지능·비용 트레이드오프
OpenAI는 단일 만능 모델에 의존하기보다 태스크의 복잡도와 경제성에 맞추어 적합한 모델을 선별 배치하는 아키텍처를 권장합니다.
- GPT-6 Astra (심층 추론 및 최고 지능): 모호한 정보 기반의 전략 수립, 복잡한 논리 설계, 법률·엔지니어링·금융 등 고도의 전문 지식이 요구되는 작업에 적합합니다. 컴퓨터 사용(Computer Use), 구조화된 출력(Structured Outputs), 프로그래밍 방식의 도구 호출, 멀티 에이전트 오케스트레이션 및 Pro 모드를 지원합니다.
- GPT-6.1 Sol (코딩, 리서치 및 지식 작업): 복잡한 프로그래밍, 장시간 진행되는 리서치, 사이버 보안, 컴퓨터 사용 등 실무 작업 전반을 처리하도록 설계되었습니다. Astra에 근접한 지능을 제공하면서도 100만 토큰당 입력 2달러, 출력 10달러 수준으로 약 5분의 1에 해당하는 비용 효율을 갖췄습니다.
- GPT-6 Luna (고반복 일상 작업 및 구조화): 청구서 항목 추출, 대량 인바운드 요청 분류, 정형화된 데이터 파싱 및 요약 등 목표가 명확한 대규모 워크플로우를 겨냥합니다. 100만 토큰당 입력 0.10달러, 출력 0.50달러로 Astra 대비 최대 100배 저렴한 비용으로 서비스 운영 부담을 최소화합니다.
가이드는 초기 개발 단계에서 가장 뛰어난 성능의 모델(Astra)로 목표 정확도를 먼저 달성한 뒤, 검증된 평가 데이터셋을 바탕으로 Sol이나 Luna 같은 경량 모델로 다운스케일링 및 증류(distillation)를 진행하는 2단계 최적화 전략을 권장합니다.
최대 95% 프롬프트 캐싱과 세션 내 configuration_update 캐시 보존
API 호출 비용과 지연 시간을 낮추기 위한 핵심 인프라 기법으로 입력 프롬프트 캐싱이 강조되었습니다.
- 최대 95% 캐시 할인: 프롬프트 접두부(prefix)가 캐시와 일치할 경우 모델에 따라 캐시된 입력 토큰 비용이 최대 95%까지 할인됩니다. (예: Astra 기준 일반 입력 10달러 대비 캐시 입력 1달러, Sol 기준 2달러 대비 0.10달러)
- 추론 수준 조절과 캐시 충돌 방지: API는 작업 난이도에 맞춰 추론 수준(
none,minimal,low,medium,high,max)을 조절할 수 있습니다. 그러나 대화 중간에 요청 단위의reasoning.effort(Responses API)나reasoning_effort(Chat Completions API) 파라미터를 임의로 변경하면 프롬프트 접두부 해시가 어긋나 기존 캐시가 무효화되는 문제가 발생합니다. configuration_update입력 활용: OpenAI는 세션 대화 도중 추론 수준을 전환할 때configuration_update항목을 사용할 것을 권장합니다. 이를 통해 기존 프롬프트 접두부 캐시를 온전히 유지하면서 어려운 단계에서는 추론 강도를 높이고 후속 일상 질의에서는 낮추는 동적 제어가 가능해집니다.
'출력 토큰 50% 감축' 지연 시간 법칙과 컨텍스트 압축
실제 프로덕션 환경에서 지연 시간을 단축하기 위한 실전 경험칙도 상세히 공개되었습니다.
- 출력 토큰 감축의 결정적 영향: LLM 파이프라인에서 지연 시간이 가장 크게 발생하는 병목 구간은 토큰 생성(Generation) 단계입니다. 일반적인 경험칙에 따르면 출력 토큰 수를 50% 줄이면 지연 시간이 약 50% 단축됩니다. 반면 프롬프트(입력) 길이를 50% 줄이더라도 지연 시간 개선 폭은 1~5%에 불과하므로, 속도 최적화의 초점은 불필요한 출력 서술을 억제하는 데 두어야 합니다.
- 예측 출력(Predicted Outputs) 활용: 코드 리팩토링이나 정형 템플릿 변환처럼 출력의 상당 부분을 미리 예측할 수 있는 작업의 경우 예측 출력 기법을 활용해 토큰 생성 지연 시간을 대폭 축소할 수 있습니다.
- 장기 작업을 위한 컨텍스트 압축(Compaction): 수 시간에서 며칠 동안 지속되는 자율 에이전트 워크플로우에서는 컨텍스트 윈도우 한계와 지연 시간 누적을 방지하기 위해 정기적인 컨텍스트 압축(Compaction) 기법을 적용해야 합니다. 중요한 상태 정보와 도구 호출 이력만 구조화하여 남김으로써 세션의 지속성과 응답 속도를 동시에 확보합니다.
엔터프라이즈 도입 성과와 프로덕션 점검 항목
이번 가이드에는 실제 프로덕션 환경에 GPT-6 제품군과 최적화 기법을 적용한 엔터프라이즈 고객사들의 사례가 함께 수록되었습니다.
- InVideo: 비디오 제작 파이프라인에서 정밀 색 보정(color correction/grading) 작업의 자동화 성공률이 기존 대비 약 3배 향상되었습니다.
- Harvey, Cognition, Hex: 법률 문서 분석(Harvey), 자율형 소프트웨어 엔지니어링 에이전트(Cognition), 데이터 분석 워크플로우(Hex) 등 각 분야의 전문 에이전트들이 Astra의 심층 추론과 구조화된 도구 오케스트레이션을 기반으로 작업 완결성을 높였습니다.
OpenAI는 서비스를 실제 배포하기 전 필수적으로 점검해야 할 항목으로 평가 메트릭 기준치 수립, 실패 시 폴백(fallback) 경로 마련, 세션 상태 압축 주기 검증, 그리고 추론 강도별 비용 시뮬레이션을 제시했습니다.
출처
- OpenAI 공식 엔지니어링 가이드: A model guide for the GPT-6 family
- OpenAI API 공식 문서: Latest Model Guide & Latency Optimization
- Lucas (@lucas_flatwhite) X 포스트: 2026-10-05 GPT-6 Family Model Guide Commentary