엔비디아 Auto Ontology 살펴보기: AI 에이전트 데이터 추론을 위한 시맨틱 온톨로지 프레임워크
엔터프라이즈 메타데이터로부터 비즈니스 온톨로지를 구축하고 생성된 NL-to-SQL 질의를 공인된 정의와 계보에 대조 검증하며 AI 에이전트에 컨텍스트를 제공하는 엔비디아의 오픈소스 프레임워크 구조와 실행 방법을 정리합니다.
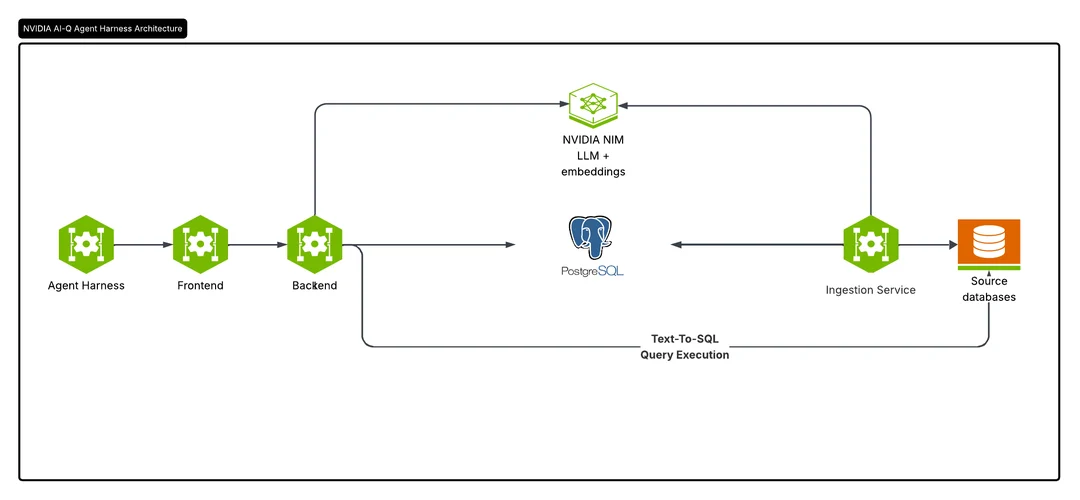
엔비디아(NVIDIA)가 오픈소스로 공개해 관리 중인 'Auto Ontology'는 정형 데이터베이스와 비즈니스 메타데이터 사이에 시맨틱 지식 그래프 계층을 구축하는 파이썬 기반 데이터 추론 프레임워크입니다. 2026년 4월 저장소가 생성된 이후 업데이트되고 있으며, LLM 에이전트가 관계형 데이터베이스를 조회할 때 비즈니스 의미, 공인된 정의, 데이터 계보를 확인할 수 있는 컨텍스트 레이어를 제공합니다.
이미지 출처: https://github.com/NVIDIA/auto-ontology
에이전트가 데이터베이스에 자연어 질의를 수행하는 Text-to-SQL 작업에서 신뢰성은 핵심 과제입니다. 각 부서나 시스템마다 매출, 고객, 제품 등의 정의가 상이할 경우 에이전트가 생성한 SQL은 문법상 유효하더라도 비즈니스 관점에서 왜곡된 수치를 반환할 수 있습니다. Auto Ontology는 엔터프라이즈 메타데이터로부터 온톨로지를 구축하고 불일치하는 정의를 조정하여, MCP, CLI, API를 통해 에이전트 하네스에 신뢰할 수 있는 비즈니스 컨텍스트를 제공합니다.
엔터프라이즈 메타데이터 기반 온톨로지 자동 생성과 데이터 검증
Auto Ontology는 검색(Discover), 접지(Ground), 검증(Validate), 제공(Expose), 학습(Learn)의 5가지 핵심 기능을 제시합니다.
- 온톨로지 자동 생성 및 접지: 메타데이터에서 엔터프라이즈 온톨로지를 생성하고, 기존 온톨로지와 시맨틱 모델을 연결해 AI용 지식 그래프를 구축하며, 시스템 간 불일치하는 정의를 조정합니다.
- 결과 검증 및 계보 추적: 에이전트가 생성한 질의를 공인된 온톨로지 정의와 데이터 계보(lineage)에 대조 검증하며, 최종 답변과 함께 생성된 SQL 및 처리 단계를 사용자에게 반환합니다.
- 답변 불가 질의 판별: 데이터베이스에 존재하지 않는 지표(예: 광고 집행 데이터가 없는 영업 DB에 광고 수익률 질의)가 입력되면 모호하게 추정하지 않고 커버리지를 계산해 사용자에게 데이터 부재 사실을 명시적으로 안내합니다.
- 지속적 학습: 공인된 수정 사항과 사용 내역을 온톨로지에 반영해 질문이 이어질수록 공유 컨텍스트를 개선합니다.
풀스택 아키텍처 구성과 NVIDIA NIM 모델 파이프라인
프레임워크는 웹 UI와 수집 워커를 포함한 여러 서비스로 구성되며, Docker Compose 또는 Kubernetes용 Helm 차트로 배포할 수 있습니다.
- 프론트엔드 (Port 3000): Next.js 16(React 19, TypeScript, Tailwind CSS 4) 기반으로 구축되었으며, Better Auth를 통한 인증 및 RBAC(역할 기반 접근 제어), Prisma를 포함합니다.
- 백엔드 코어 (Port 3001): FastAPI(Python 3.12+)와 LangChain을 결합하여 대화형 인터페이스, NL-to-SQL 엔진, 데이터 카탈로그 및 데이터소스 연동 API를 처리합니다.
- 데이터 수집 워커 (Port 3002): FastAPI 기반의 별도 워커 서비스로 테이블 형식 데이터를 수집하고 벡터 임베딩 생성을 담당합니다.
- 데이터 저장소 (Port 5432): Postgres와 pgvector 확장 기능을 활용해 애플리케이션 메타데이터, 카탈로그 및 온톨로지 스키마, 벡터 임베딩을 단일 인프라에서 통합 관리합니다. 접속 자격 증명의 안전한 보관을 위해 HashiCorp Vault를 선택적으로 연동할 수 있습니다.
추론 파이프라인은 NVIDIA NIM 엔드포인트를 기본 엔진으로 활용합니다. 호스팅 서비스인 NVIDIA API 카탈로그(integrate.api.nvidia.com) 또는 자체 호스팅 NIM 인스턴스를 지정할 수 있으며, 기본 설정 모델 구성은 다음과 같습니다.
- 추론 및 자연어 질의 (LLM):
nvidia/nemotron-3.5-lightning-30b-a3b - 텍스트 임베딩 (Embeddings):
nvidia/nemotron-3-embed-1b - 검색 리랭킹 (Reranking):
nvidia/llama-nemotron-rerank-vl-1b-v2
각 모델 역할은 엔드포인트 URL, API 키, 모델명으로 이뤄진 환경 변수 트리플릿(Triplet)으로 관리되며, 상위 기본값(DEFAULT_MODELS_*)을 통해 공통 엔드포인트를 손쉽게 상속받을 수 있습니다.
빠른 시작 가이드와 라이선스 정책
로컬 환경에서는 Docker Compose v2와 uv를 함께 사용해 마이크로소프트의 샘플 판매 데이터베이스(Wide World Importers)를 기반으로 테스트 환경을 빠르게 배포할 수 있습니다.
- 저장소 복제 및 환경 변수 설정: 저장소를 복제한 뒤
.env.example파일을 복사해.env를 생성하고, 발급받은 NVIDIA API 키(DEFAULT_MODELS_API_KEY) 및 Postgres, 관리자 계정 암호를 지정합니다. - Postgres 시작 및 샘플 데이터 로드: Docker Compose로 Postgres 컨테이너를 올린 후, 평가용 저장소(
auto-ontology-eval)의 시드 스크립트를 실행해 샘플 데이터베이스를 구축합니다. - 전체 스택 빌드 및 실행:
docker compose up -d --build명령으로 웹 UI와 백엔드 서비스를 실행하고 브라우저에서http://localhost:3000에 접속합니다. - 시맨틱 컴파일 활성화: 설정 메뉴에서 시맨틱 컴파일(Semantic Compilation)을 활성화합니다. 수집은 시작 시 실행되며, 컴파일이 완료되어 Semantic compilation is ready가 표시되면 자연어 질의를 사용할 수 있습니다.
Auto Ontology는 Apache License 2.0 라이선스로 배포됩니다. 저장소 공식 안내에 따르면 현재 외부 기여(external contributions)는 접수하지 않습니다.
출처
- GitHub: NVIDIA/auto-ontology