상하이 인공지능 연구소, 512K 컨텍스트 지원하는 Atria Dawn 정식 버전 공개
상하이 인공지능 연구소가 512K 토큰 컨텍스트를 지원하는 Atria Dawn 정식 버전을 API로 출시했습니다. 20개 공식 벤치마크 중 17개 항목에서 성능이 향상되었으나 자체 서버용 모델 가중치 배포는 아직 보류 중입니다.
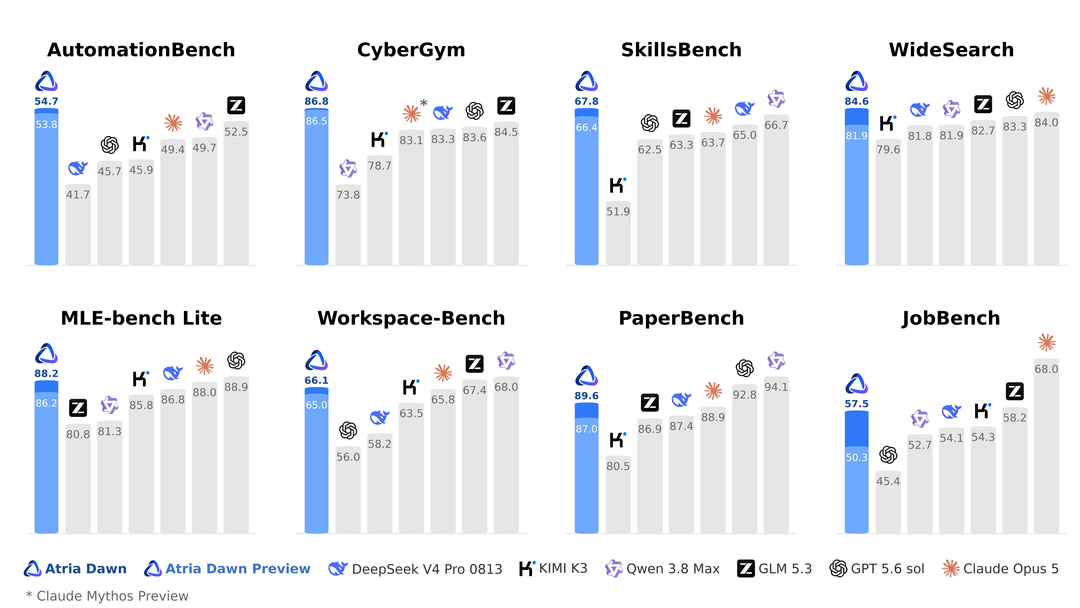
이미지 출처: https://github.com/atria-asi/Atria-Dawn/blob/main/assets/evaluation.jpg

512K 토큰 API 지원과 정식 버전 공개
상하이 인공지능 연구소(Shanghai AI Lab)가 연구 및 소프트웨어 개발과 같은 복합 워크플로를 수행하도록 설계된 Atria Dawn의 정식 버전을 공개했습니다. 이번 릴리스에서 공식 API는 최대 512K 토큰의 컨텍스트 길이를 지원하며, 이는 프리뷰 버전에서 제공되던 256K 제한의 두 배에 달하는 수치입니다. Atria Dawn은 7,440억 개의 매개변수를 갖춘 GLM-5.2 기반 모델로, 전문가 혼합(MoE) 아키텍처를 채택해 다양한 단계의 도구 활용과 문제 분석, 코드 작성, 실험 검증 작업을 아우르는 종합 에이전트 역할을 목표로 합니다. 공식 API 문서에 따르면 512K 제한은 입력 프롬프트와 생성 출력을 모두 합산한 수치이며, 단일 응답 출력 토큰 설정은 1부터 65,536까지 지원됩니다.
20개 공식 벤치마크 중 17개 항목 개선
공식 깃허브 저장소에 공개된 평가 결과에 따르면, 프리뷰 버전과 비교 가능한 20개 벤치마크 중 정식 버전은 17개 항목에서 점수가 상승했습니다. 실무 작업 평가인 JobBench에서 점수가 50.3점에서 57.5점으로 7.2점 올라 가장 큰 폭의 향상을 기록했습니다. 또한 정보 탐색 벤치마크인 WideSearch는 81.9점에서 84.6점으로 2.7점, 연구 논문 관련 PaperBench는 87.0점에서 89.6점으로 2.6점 개선되었습니다. 소프트웨어 엔지니어링 역량을 측정하는 SWE-bench Pro 역시 59.6점에서 61.7점으로 올랐습니다. 반면 Harbor-Index는 17.3점으로 변동이 없었으며, BrowseComp는 92.5점에서 91.3점으로, NL2Repo-Bench는 51.4점에서 50.0점으로 소폭 하락해 모든 작업 지표에서 일괄 상승한 것은 아닙니다.
로컬 가중치 공개 보류와 실무 환경의 제약
확장된 문맥 창과 벤치마크 향상에도 불구하고 실무 도입 시 확인해야 할 제약 사항이 존재합니다. 연구소 측은 전체 모델 가중치를 아직 다운로드용으로 배포하지 않았으며, 허깅페이스와 모델스코프에는 정식 버전 가중치가 준비 중(Coming soon)으로 표시되어 있습니다. 이에 따라 로컬 인프라나 자체 호스팅 서버에서 즉시 구동할 수 있었던 프리뷰 버전과 달리, 정식 버전은 현재 공식 API 호출을 통해서만 이용할 수 있습니다. 아울러 공식 API 문서는 512K 토큰을 명시하고 있지만 깃허브 배포 표에는 256K로 기재되어 있는 차이가 있어, 향후 로컬 가중치가 배포될 때 동일한 512K 컨텍스트가 로컬 환경에 적용될지는 확정되지 않았습니다. 장기 작업 시 문맥 관리 전략과 API 의존성을 고려한 도입 계획이 필요합니다.