앤트, Ming-3.0 오디오 제품군 공개: 0.5B 제로샷 음성 모델과 온디바이스 음성 상호작용 파이프라인
앤트가 Ming-3.0 오디오 제품군을 공개했습니다. 인공분석 제어 음성 평가 1위를 기록한 0.5B TTS 모델과 음성 인식 및 이해를 위한 MoE 제품군으로 로컬 파이프라인을 지원하지만 GGUF 및 소비자 GPU 벤치마크는 미제공 상태입니다.
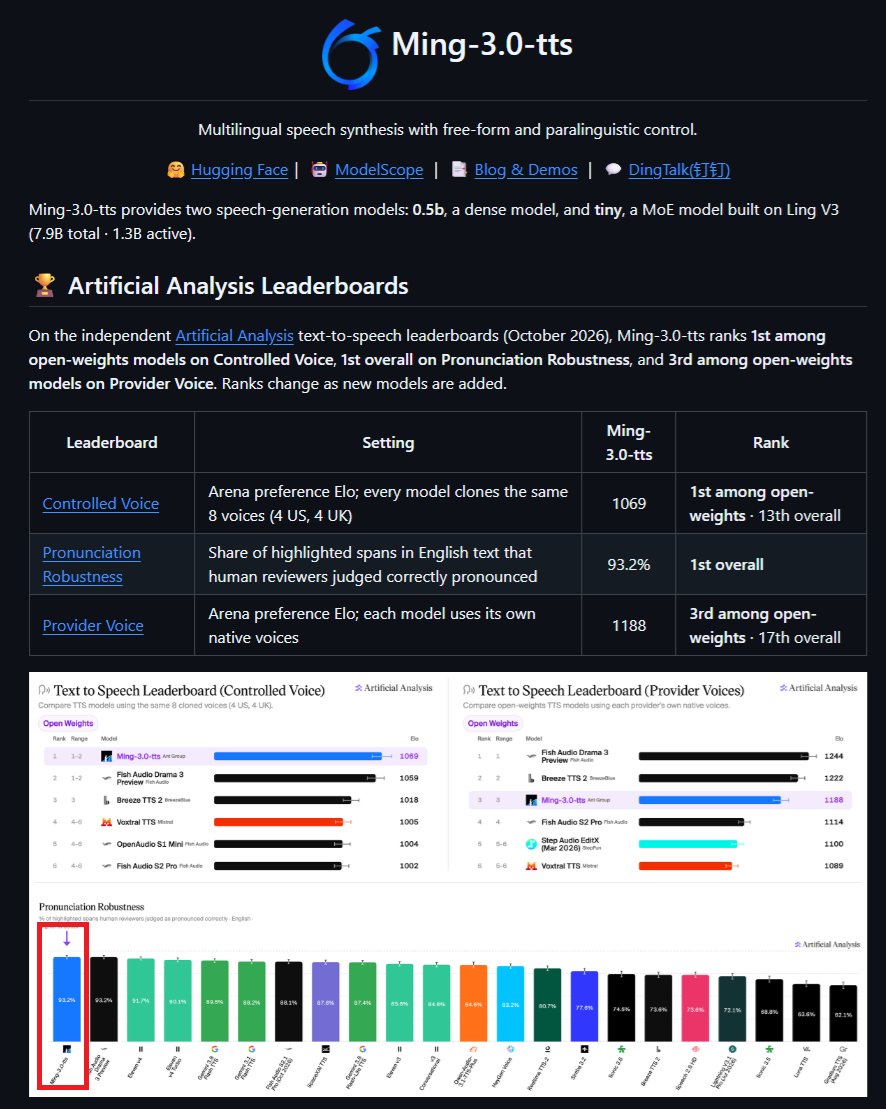
이미지 출처: @TeksEdge via X
2026년 10월 20일 테크 분석가 데이비드 헨드릭슨(@TeksEdge)에 따르면, 앤트(Ant)가 고품질 음성 합성과 로컬 상호작용을 지원하는 오픈소스 오디오 모델군 'Ming-3.0'을 공개했습니다. 이번 릴리스의 핵심인 Ming-3.0-TTS-0.5B는 5억 개(0.5B) 매개변수의 고밀도(dense) 모델로, 인공분석(Artificial Analysis)의 제어 음성 벤치마크에서 엘로(Elo) 1069점을 기록하며 오픈웨이트 1위에 올랐습니다. 소형 모델임에도 정교한 제어력을 선보이며 로컬 오디오 AI 진영에 큰 주목을 받고 있습니다.
초소형 고밀도 TTS: 자연어 음성 설계와 비언어적 표현
핵심 모델인 Ming-3.0-TTS-0.5B는 0.5B 규모의 콤팩트한 구조에도 강력한 표현 통제 기능을 제공합니다. 대상 화자의 특징을 빠르게 복제하는 제로샷(zero-shot) 음성 복제를 지원하며, 자연어 지시문을 통한 맞춤형 음성 디자인이 가능합니다. 발화자의 감정과 말하는 속도, 음조(pitch), 문장 내 강조(emphasis)를 정밀하게 조절할 수 있도록 구성되었습니다.
아울러 소형 오픈소스 모델에서 다루기 어려웠던 비언어적 발화 요소들이 포함되었습니다. 대화 중 자연스러운 웃음소리, 한숨, 기침, 호흡, 머뭇거림 같은 간투사를 생성 음성에 정교하게 반영할 수 있습니다. 7개 언어를 지원하며, 44.1 kHz 고해상도 오디오 출력을 갖춰 인터랙티브 서비스에 적합한 품질을 확보했습니다.
MoE 제품군으로 완성하는 로컬 음성 상호작용 파이프라인
앤트는 단일 TTS를 넘어 로컬 환경에서 음성 인터랙션을 완결할 수 있는 MoE(Mixture of Experts) 오디오 제품군을 함께 내놓았습니다. 대화형 음성 합성을 위한 Ming-3.0-TTS-Tiny는 총 7.9B 중 1.3B 활성 파라미터로 구동되며 다자간 대화와 장문 음성 합성을 지원합니다.
입력 및 이해 단계는 방언과 악센트, 맥락적 핫워드를 처리하는 음성 인식 모델 Ming-3.0-ASR-Tiny(총 8.6B / 활성 ~2B)가 담당합니다. 여기에 음성뿐 아니라 음악과 환경 음향까지 인지하며 음성 질의응답을 수행하는 Ming-3.0-Audio-Tiny(총 9.3B / 활성 2.7B)가 결합됩니다. 대규모 추론을 위해서는 126B 총 파라미터 중 6.5B 활성 파라미터로 작동하는 Ming-3.0-Audio-Flash가 제공됩니다. 이로써 외부 클라우드 통신 없이 기기 내부에서 듣고(hear), 이해하며(understand), 의사결정을 거쳐 복제·설계된 음성으로 답하는(speak) 로컬 스피치-투-스피치 파이프라인이 구성됩니다.
현실적인 배포 제약과 검증의 과제
다만 실제 로컬 기기에 즉시 배포하여 활용하기에는 몇 가지 현실적인 제약이 존재합니다. 현재 시점에서는 로컬 추론 생태계에서 널리 활용되는 GGUF 포맷이나 llama.cpp 런타임이 아직 지원되지 않습니다. 따라서 독립 바이너리나 경량 실행 환경을 구성하려는 개발자들에게는 즉각적인 도입 장벽이 있습니다.
또한 소비자용 GPU(consumer GPU) 환경에서의 구체적인 실행 성능이나 지연 시간(latency) 벤치마크 결과가 아직 제공되지 않았습니다. 0.5B 고밀도 모델과 1.3B~6.5B 활성 파라미터 MoE 구조는 온디바이스 구동에 유리한 잠재력을 지녔지만, 실시간 대화에 부합하는 레이턴시가 실제로 확보되는지는 추후 공개될 커뮤니티 실측 결과와 최적화 런타임을 통해 검증될 필요가 있습니다.