RTX 5070 12GB 환경에서 MiniMax H3 15초 핸드헬드 비디오 로컬 생성 워크플로우
RTX 5070 12GB 단일 GPU 환경에서 MiniMax H3 Hybrid V2 INT8 모델과 Turbo LoRA를 활용해 15초 핸드헬드 영상을 ComfyUI로 로컬 생성하는 설정법, 7~8분 생성 시간 실측치 및 구조화된 프롬프트 워크플로우.
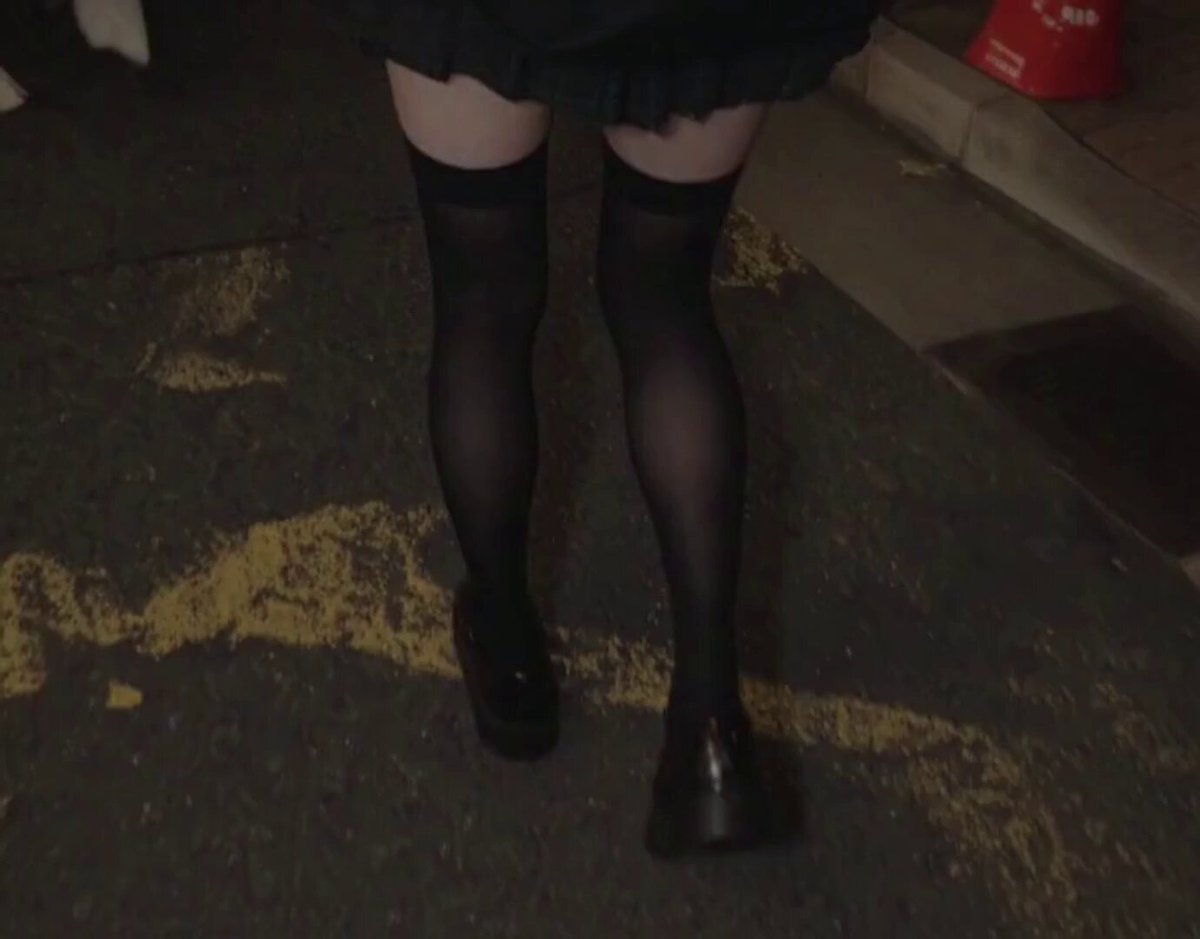
AI 비디오 크리에이터이자 엔지니어인 Tom𝕎(@Tomw852)가 엔비디아 지포스 RTX 5070 12GB 단일 그래픽카드 환경에서 오픈웨이트 비디오 모델인 MiniMax H3(DaSiWa Hybrid V2 INT8)와 Turbo LoRA를 활용해 15초 분량의 핸드헬드 시부야 야경 영상을 로컬 ComfyUI로 생성하는 실전 워크플로우와 실측 벤치마크 데이터를 공개했습니다.
이미지 출처: Tom𝕎 (@Tomw852)
고품질 AI 비디오 모델은 일반적으로 수십 기가바이트 이상의 VRAM을 요구하여 상용 클라우드 API에 의존하는 경우가 많았습니다. 이번 워크플로우는 12GB VRAM을 갖춘 메인스트림 소비자용 GPU인 RTX 5070에서 양자화 모델과 고속 스텝 추론 LoRA를 조합해 로컬 환경에서도 실용적인 비디오 생성이 가능함을 입증한 사례로 주목받고 있습니다.
모델 및 LoRA 스택: INT8 양자화와 가속 파이프라인 구성
Tom𝕎가 공개한 로컬 비디오 생성 파이프라인의 핵심은 대형 파운데이션 모델을 12GB VRAM 제약 안으로 압축하면서도 인물 질감과 생성 속도를 동시에 확보한 3단 결합 구조입니다.
- 기본 모델(Base Model): DaSiWa MiniMax H3 Hybrid V2 INT8 모델을 베이스로 사용합니다. 원본 FP16 가중치를 8비트 정수(INT8)로 정밀하게 하이브리드 양자화하여, 모델 로딩 시 요구되는 비디오 메모리 점유율을 대폭 낮추면서도 H3 특유의 사실적인 물리 법칙과 시공간 연속성을 보존합니다.
- 가속 LoRA(LoRA 1):
MiniMax-H3-Turbo-Lora-ComfyUI Turbo V4 Step 600을 적용합니다. 기본 모델의 다단계 확산(diffusion) 스텝 수를 획기적으로 줄여 추론 속도를 배속화하는 터보 가속 어댑터입니다. - 인물 사실감 LoRA(LoRA 2):
Realism People LoRA를 중첩 결합합니다. 피부의 미세한 텍스처와 미세 표정, 인물 외곽선 주변의 자연스러운 렌더링 품질을 보강하여 AI 영상 특유의 플라스틱 느낌을 억제합니다.
이러한 조합을 통해 고가의 엔터프라이즈 서버 없이도 단일 12GB VRAM 카드에서 ComfyUI 노드 그래프를 완결형으로 구성할 수 있습니다.
구조화된 프롬프트 아키텍처: 다중 참조와 시계열 연출
Tom𝕎는 15초 동안 인물의 일관성과 핸드헬드 카메라 워크를 흔들림 없이 유지하기 위해 모듈형 구조화 프롬프트(Structured Prompt Architecture) 방식을 적용했습니다.
1. 피사체 및 환경 정의 (subject_definitions)
프롬프트 상단에서 다중 레퍼런스 이미지를 각각의 독립된 역할로 명시적으로 바인딩합니다.
[subject_definitions]
<Picture 1> represents the character identity (S1): a young Japanese subculture elf girl with messy bleach-blonde layered wolf-cut hair, prominent pointed elf ears with metallic dangle earrings, dark choker necklace, oversized washed-black canvas work jacket worn loose over an untucked white collared school shirt, loosened red-and-black striped tie, dark pleated skirt, sheer black over-knee stockings, and black platform loafers. Slender build, expressive sleepy dark eyes with subtle red-tinted lower eyelid shading, pale skin with delicate natural micro-texture.

<Picture 2> represents the visual environment, camera style, and aesthetic reference: Shibuya night street at 1:00 AM, gritty real-life Japanese handheld companion vlog style, on-camera flash illumination mixed with distant Shibuya neon signage, natural film grain, authentic organic camera sway, and subtle motion blur.
<Picture 1>: 캐릭터의 정체성(S1)을 정의합니다. 표백된 금발 레이어드 울프컷, 금속 귀걸이가 달린 뾰족한 엘프 귀, 초커 목걸이, 워싱된 블랙 캔버스 워크 재킷, 풀어헤친 넥타이, 짙은 주름치마와 통굽 로퍼 등 의상과 외모의 디테일을 구체적으로 명시합니다.<Picture 2>: 새벽 1시의 시부야 밤거리 환경과 핸드헬드 동행 브이로그 카메라 스타일, 카메라 온보드 플래시 직광 조명과 네온 간판, 자연스러운 필름 그레인과 모션 블러를 지정합니다.
2. 영상 요약 및 유지 요소 분석 (summary & retention_analysis)
[summary]
A realistic 15-second first-person companion vlog in Shibuya at night. The silent cameraman quietly follows and records the blonde elf girl (S1) walking down a neon-lit Tokyo backstreet. S1 notices the continuous filming, delivers a couple of soft, intimate lines directly into the camera lens with genuine micro-expressions, while the cameraman remains completely silent.

[retention_analysis]
- Character identity, clothing, hair, and elf ears: exact match from <Picture 1>.
- Lighting, atmosphere, direct-flash photography aesthetic, and Tokyo city backdrop: exact match from <Picture 2>.
- Cameraman presence: strictly non-speaking visual POV only.
요약 블록에서는 카메라맨이 말을 하지 않는 순수 1인칭 시점(POV)임을 명시하고, 엘프 소녀(S1)가 촬영을 의식하며 렌즈를 향해 조용하고 친밀한 대사를 건네는 상황을 설정합니다. 유지 분석(Retention Analysis) 항목을 통해 레퍼런스 이미지에서 반드시 보존해야 할 캐릭터 특징과 배경 조명을 모델에 강력하게 지시합니다.
3. 타임코드 기반 세부 묘사 (detailed_description)
[detailed_description]
From 00:00.000 to 00:05.200:
First-person eye-level handheld camera shot (28mm prime lens, f/2.0, soft on-camera fill light). The camera follows closely behind <Subject 1> (S1) as she walks leisurely down a Shibuya side street. S1 senses the quiet camera, slows her pace, and turns her upper body back toward the lens over her shoulder.
렌즈 화각(28mm 단렌즈, f/2.0)과 카메라 눈높이를 지정하고, 초반 5.2초 동안 인물이 뒤를 돌아보며 렌즈를 응시하는 동작 전개를 타임스탬프 단위로 정밀하게 통제합니다.
하드웨어 실측 벤치마크와 12GB VRAM 운용 시 주의점
Tom𝕎는 생성 시간에 관한 커뮤니티 질문(@JCaravotas)에 대해 "RTX 5070 로컬 환경에서 15초 분량 영상을 생성하는 데 대략 7분에서 8분(roughly 7mins~8mins)이 소요되었다"고 구체적인 실측치를 밝혔습니다.
클라우드 렌더팜이나 24GB~80GB 고용량 VRAM 환경에 비하면 생성 시간이 다소 소요되지만, 단일 소비자용 12GB 그래픽카드에서 추가 비용 없이 15초 고화질 영상을 완주해냈다는 점에서 실용적 가치가 입증되었습니다.
하지만 실무 도입 시 고려해야 할 현실적인 한계와 메모리 병목에 대해서도 개발자 커뮤니티의 중요한 피드백이 이어졌습니다.
- 연속 생성과 메모리 헤드룸의 한계: AI 엔지니어 xxxbaaa(@xxxbaaa07gk)는 "RTX 5070 12GB 환경에서 MiniMax H3를 ComfyUI에 구동한 것은 매우 인상적인 성과이지만, 15초 단일 클립 완주에만 현혹되어서는 안 된다"고 경고했습니다. VAE 디코딩 단계와 중첩된 LoRA 가중치 연산, 실패 시 반복 재실행 과정에서 VRAM 여유 버퍼가 매우 빠듯하기 때문에 "단발성 생성이 성공했다고 해서 안정적인 연속 배치가 가능한 것은 아니며, 진짜 문턱은 메모리 부족(OOM) 없이 연속 10회 생성을 버텨내는 것"이라고 분석했습니다.
- LoRA 스택과 실시간성 검증: ArtRealmAI(@ArtRealmAI) 역시 "12GB VRAM이라는 제약 조건 속에서 H3를 로컬로 구동한 것은 창작자에게 대단히 유용한 기준점"이라고 평가하면서도, "핸드헬드 연출 결과물은 매우 뛰어나지만 다중 LoRA 스택이 추가되거나 클립 길이가 늘어날 때 안정적인 생성 효율이 유지되는지 지속적인 검증이 필요하다"고 덧붙였습니다.
따라서 12GB GPU 사용자는 ComfyUI 구동 시 백그라운드 VRAM 점유 앱을 완전히 종료하고, VAE 타일링(Tiling) 옵션과 메모리 언로드 설정을 적극적으로 활용하여 피크 메모리 스파이크를 방어해야 합니다.
원문 출처
- X (구 트위터) @Tomw852 원문 포스트: 15s handheld Shibuya night walk with MiniMax H3 locally on RTX 5070 12GB
- DaSiWa MiniMax H3 Hybrid V2 INT8 베이스 모델: Civitai 저장소
- MiniMax-H3-Turbo-Lora-ComfyUI 가속 LoRA: Hugging Face 저장소
- MiniMax-H3-Realism-People-LoRA 사실감 LoRA: Hugging Face 저장소
- 원작자 및 기술 피드백 기여자: Tom𝕎 (@Tomw852), Jimmy Caravotas (@JCaravotas), xxxbaaa (@xxxbaaa07gk), ArtRealmAI (@ArtRealmAI)