AI가 제대로 동작하는지 검증하는 오픈소스 LLM 평가·테스트 도구 모음
DeepEval, Promptfoo, Ragas, Opik, Arize Phoenix 등 LLM과 AI 에이전트의 환각 검증, RAG 검색 품질 측정, 실행 추적과 관측성 확보를 돕는 핵심 오픈소스 도구들을 정리했습니다.
X 계정 @RodmanAi(Leonard Rodman)가 2026년 10월 3일, "AI가 실제로 동작하는지 확인할 수 있는 GitHub 저장소 10선"이라는 정리 게시물을 올렸습니다. AI 모델을 만드는 것만큼 품질을 측정하는 일이 중요해졌다는 문제의식에서, LLM과 AI 에이전트를 테스트·평가·모니터링하는 오픈소스 도구들을 한데 모은 목록입니다. 이 글에서는 데스크에서 검증된 핵심 5종(DeepEval, Promptfoo, Ragas, Opik, Arize Phoenix)의 역할과 실무상 쓰임새를 정리합니다.
DeepEval: Pytest처럼 쓰는 LLM 유닛 테스트 프레임워크
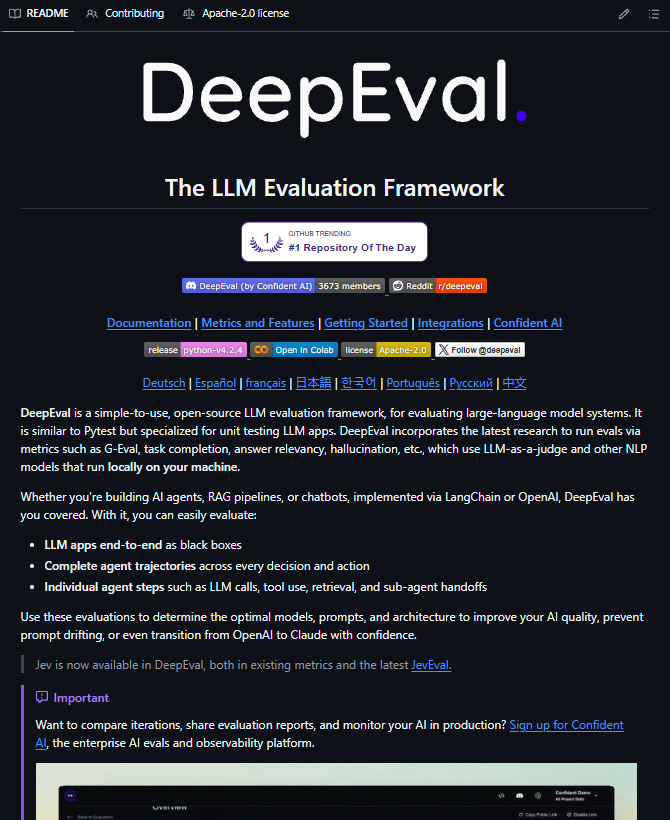
DeepEval(confident-ai/deepeval)은 Pytest와 유사한 인터페이스로 LLM 애플리케이션을 유닛 테스트하는 오픈소스 평가 프레임워크입니다. 환각 여부, 답변 관련성, RAG 파이프라인 품질, 에이전트의 의사결정 경로와 개별 단계(LLM 호출, 도구 사용 등)를 로컬 환경에서 실행되는 평가 모델로 점수화합니다.
챗봇·RAG 파이프라인·AI 에이전트를 LangChain이나 OpenAI 스택으로 만들었든, 블랙박스 종단 평가부터 에이전트 궤적 전체 추적까지 커버한다는 점이 특징입니다. 원문 게시물은 "pytest for LLMs"라는 한 줄로 요약했습니다.
Promptfoo: 프롬프트·모델 비교와 레드팀 스캐닝, CI/CD 회귀 테스트
Promptfoo(promptfoo/promptfoo)는 프롬프트와 모델별 성능을 비교하고 레드팀 취약점 스캐닝을 수행하는 CLI·라이브러리입니다. 선언적 설정 파일과 커맨드라인으로 자동 평가를 돌리고, CI/CD 파이프라인에 연결해 회귀 테스트와 보안 점검을 자동화할 수 있습니다. GPT, Claude, Gemini, DeepSeek 등 여러 모델을 나란히 비교하는 용도로 쓰입니다.
원문 게시물의 표현을 빌리면 "실패를 사용자가 먼저 겪기 전에 잡아내는" 도구입니다. 저장소 설명에 따르면 OpenAI와 Anthropic에서도 사용되며, 현재는 OpenAI에 합류한 뒤에도 MIT 라이선스 오픈소스로 유지되고 있습니다.
Ragas: RAG 시스템의 충실도·관련성·검색 품질 측정
Ragas(explodinggradients/ragas)는 검색 증강 생성(RAG) 시스템 전용 평가 도구입니다. 생성 답변이 검색된 근거에 충실한지(faithfulness), 질문과 답변이 서로 관련 있는지, 검색(retrieval) 품질 자체가 충분한지를 정량 지표로 측정합니다.
RAG를 쓰는 챗봇이라면 "답이 그럴듯한데 근거가 있는가"를 따지는 게 핵심인데, 바로 그 지점을 담당합니다. 원문 게시물도 충실도·관련성·검색 품질 세 가지 축으로 소개했습니다.
Opik과 Arize Phoenix: 실행 추적·평가·관측성
Opik(comet-ml/opik)은 AI 워크플로우를 추적(trace)하고 출력을 평가하며 LLM 애플리케이션을 디버깅하는 도구입니다. Arize Phoenix(Arize-ai/phoenix)는 LLM·에이전트 애플리케이션용 오픈소스 관측성과 평가를 제공합니다.
둘 다 "배포하고 끝"이 아니라 운영 중에 무엇이 돌아가는지 보고 문제를 찾는 영역입니다. 원문 게시물 답글에서도 Opik이 워크플로우 디버깅에 유용하다는 반응, 프로덕션 모니터링 관점에서 Evidently 같은 도구를 함께 언급한 반응이 달렸습니다.
실무에서 쓸 때 주의할 점
- LLM-as-a-Judge 방식의 한계: 판정용 LLM 자체의 편향이 들어갈 수 있고 토큰 비용이 발생합니다. 정규식·키워드 같은 규칙 기반 검증과 병행하는 구성이 권장됩니다.
- CI/CD 비용 관리: 테스트 케이스 수와 모델 호출 빈도에 따라 API 비용과 레이트 리밋을 함께 관리해야 합니다. 매 PR마다 전체 스위트를 돌리기보다 프롬프트·평가 파일 변경 시에만 게이트를 여는 방식이 현실적입니다.
출처
- Leonard Rodman (@RodmanAi) 원문 게시물: 10 GITHUB REPOS TO FIND OUT IF YOUR AI ACTUALLY WORKS
- DeepEval: confident-ai/deepeval
- Promptfoo: promptfoo/promptfoo
- Ragas: explodinggradients/ragas
- Opik: comet-ml/opik
- Arize Phoenix: Arize-ai/phoenix