리퀴드 AI, 2B 활성 파라미터 오픈 가중치 모델 'LFM2.5-24B-A2B' 공개… 35B급 에이전트 성능
리퀴드 AI가 24B 총 파라미터 중 2B만 활성화하는 오픈 가중치 모델 LFM2.5-24B-A2B를 허깅페이스에 공개했습니다. 벤치마크상 더 큰 Qwen3.6-35B-A3B와 대등한 도구 사용 및 에이전트 성능을 로컬 환경에서 지원합니다.
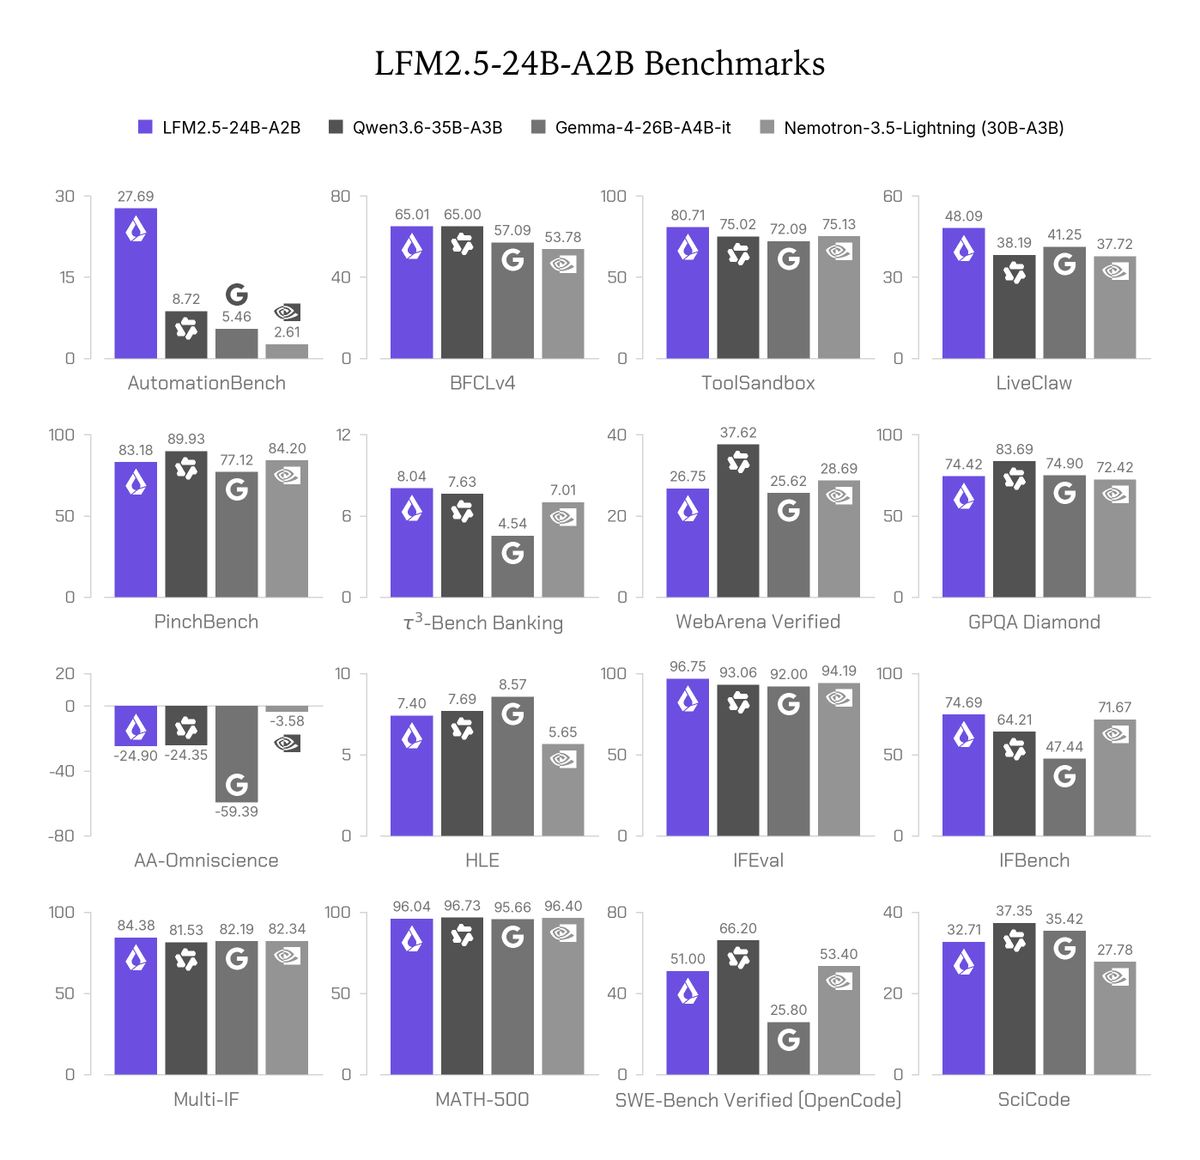
인공지능 연구 스타트업 리퀴드 AI(Liquid AI)가 2026년 10월 14일, 총 24B 파라미터 중 토큰당 약 2B만 활성화하는 오픈 가중치 모델 'LFM2.5-24B-A2B'를 공식 출시하고 가중치를 허깅페이스(Hugging Face)에 공개했습니다.
이미지 출처: @testingcatalog / Liquid AI
이번 릴리즈는 총 240억(24B) 개의 파라미터를 유지하면서도 토큰당 약 20억(2B) 개의 파라미터만 선별 활성화하는 희소(sparse) 아키텍처를 채택했습니다. 연산 부하를 2B급으로 낮추어 로컬 환경에서도 대형 모델급 도구 조작 역량을 발휘하도록 설계된 점이 특징입니다.
24B 총 파라미터 중 2B 활성화: 희소 연산 아키텍처
LFM2.5-24B-A2B의 아키텍처적 핵심은 모델 전체 가중치의 표현력을 보존하면서도 토큰 생성 시 실제 연산 부하를 2B 수준으로 대폭 경감시킨 연산 효율성에 있습니다.
모델은 입력된 토큰을 처리할 때 전체 24B 파라미터를 매번 연산에 투입하지 않고, 토큰당 약 2B에 해당하는 활성 파라미터만을 동적으로 할당해 순전파(forward pass)를 수행합니다.
- 24B 총량과 2B 활성 파라미터: 전체 파라미터 용량은 24B이지만 토큰당 연산량은 2B 규모에 집중되므로, 추론 시 요구되는 부동소수점 연산량(FLOPs)과 소비 전력을 크게 줄입니다.
- 오픈 가중치 공개: 리퀴드 AI는 허깅페이스를 통해 가중치를 공개하여 개발자들이 클라우드 API 종속 없이 로컬 추론 런타임 및 양자화 파이프라인에 모델을 연동할 수 있도록 지원합니다.
Qwen3.6-35B-A3B 대비 더 작은 파라미터로 대등한 도구 사용·에이전트 벤치마크
리퀴드 AI가 공개한 벤치마크 비교 결과에 따르면, LFM2.5-24B-A2B는 주요 도구 사용(tool-use) 및 지시 이행 평가에서 총 파라미터가 더 큰 Qwen3.6-35B-A3B(35B 총량, 3B 활성)와 대등하거나 이를 앞서는 성능을 기록했습니다.
공개된 벤치마크 차트에 따른 주요 평가 수치는 다음과 같습니다.
- 도구 사용 및 함수 호출: 함수 호출 벤치마크인 BFCLv4에서 65.01점을 기록해 Qwen3.6-35B-A3B(65.00점)와 동등한 결과를 보였으며, ToolSandbox에서는 80.71점으로 Qwen(75.02점), Gemma-4-26B-A4B-it(72.09점), Nemotron-3.5-Lightning(75.13점)을 상회했습니다.
- 자동화 및 지시 이행: AutomationBench에서 27.69점(Qwen: 8.72점), LiveClaw에서 48.09점(Qwen: 38.19점), IFEval에서 96.75점(Qwen: 93.06점), IFBench에서 74.69점(Qwen: 64.21점)을 기록했습니다.
- 기타 작업 비교: MATH-500에서는 96.04점으로 Qwen(96.73점)과 대등한 수준을 보였습니다. 반면 SWE-Bench Verified(OpenCode)에서는 51.00점(Qwen: 66.20점), WebArena Verified에서는 26.75점(Qwen: 37.62점), GPQA Diamond에서는 74.42점(Qwen: 83.69점)으로 복합 코딩 및 심층 웹 에이전트 평가에서는 Qwen3.6-35B-A3B가 우세를 유지했습니다.
24B 메모리 적재 요구량과 초기 실측 피드백
로컬 머신 환경에서 LFM2.5-24B-A2B를 활용할 때는 하드웨어 메모리 요구 특성과 실전 에이전트 하네스에서의 동작 차이를 분별해야 합니다.
가장 먼저 확인해야 할 부분은 메모리 용량입니다. 토큰당 연산 속도는 2B 수준으로 빠르지만, 추론을 구동하려면 전체 24B 파라미터 가중치가 RAM 또는 VRAM에 모두 적재되어야 합니다. 커뮤니티 개발자들 역시 연산 속도와 별개로 전체 24B 가중치를 수용할 수 있는 로컬 메모리 확보가 핵심 사양이라고 지적하고 있습니다.
또한 초기 실측 사용자 평가에서는 정형 벤치마크와 실무 체감 성능 간의 차이에 대한 피드백도 제기되었습니다.
- 도구 반환 결과 소화: MLX Q8 및 Pi 하네스 환경에서 검색 및 페치(Search + fetch) 도구를 연동해 사실 확인 질의를 수행한 초기 테스터(M. Kasinski)는, 도구 호출 자체는 정상 실행되나 반환된 도구 출력을 소화해 종합 답변을 도출하는 과정에서 Qwen3.6-35B 대비 아쉬운 결과를 보였다고 평가했습니다.
- 작업별 실측 검증 권장: 합성 벤치마크 수치에 전적으로 의존하기보다는, 로컬 배치 번역이나 정형 데이터 처리 등 2B급 경량 연산의 이점을 살릴 수 있는 구체적인 워크플로우를 중심으로 직접 성능을 검증하는 접근이 필요합니다.
출처
- Liquid AI 공식 X 발표: LFM2.5-24B-A2B Release Announcement
- TestingCatalog (@testingcatalog): Liquid AI LFM2.5-24B-A2B Benchmark Analysis and Open Weights Release