Jev의 오픈소스 로컬 대안 'Laya': 인코더 기반 고속 판단 모델 아키텍처
호스팅 전용 의사결정 API인 Jev를 대체하는 Apache 2.0 라이선스의 로컬 오픈소스 판단 모델 Laya의 동작 원리와 35ms 벤치마크, 미세조정 전략 정리.
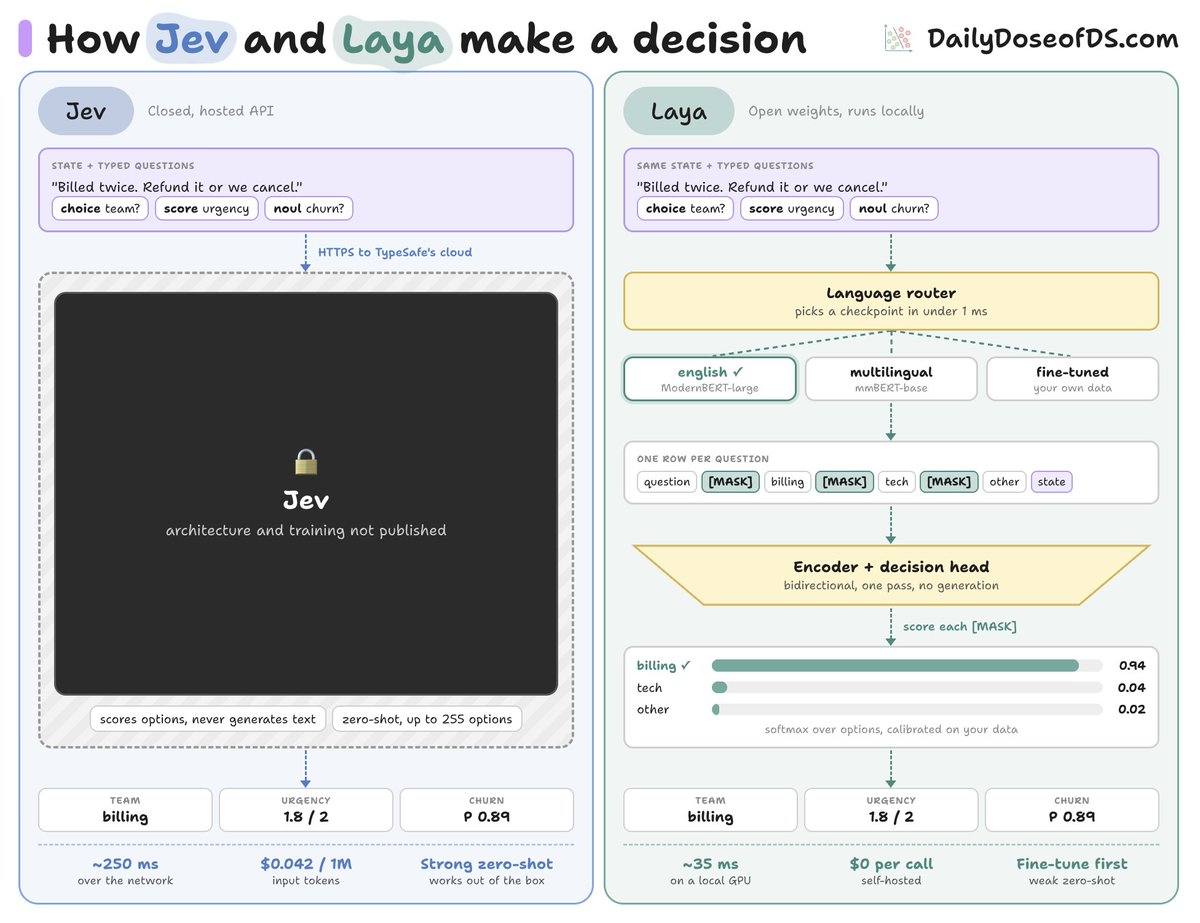
비정형 상태 데이터와 타입화된 질문을 입력받아 정해진 선택지 중 최적의 답과 확률 분포를 도출하는 '의사결정 모델(Decision Model)' 생태계에 완전 오픈소스 로컬 대안이 등장했습니다. 머신러닝 연구자 악샤이 파차르(Akshay Pachaar)는 호스팅 API 전용 모델인 Jev의 오픈소스 로컬 대안 모델인 Laya의 파이프라인 구조와 벤치마크를 공개했습니다.
이미지 출처: @akshay_pachaar
Laya는 Apache 2.0 라이선스로 배포되는 100% 오픈소스 가중치 모델입니다. LLM의 긴 텍스트 생성 대신, 사전 정의된 선택지 집합에서 확률 분포(Softmax)를 반환해 코드 레벨에서 즉각적인 조건 분기와 제어가 가능하도록 설계되었습니다.
양방향 인코더 기반 의사결정 파이프라인 동작 원리
Jev와 Laya는 모두 비정형 상태 텍스트(State)와 타입화된 질문(Question)을 받아 프로그래밍에 활용할 수 있는 확률값을 반환하는 동일한 문제를 해결하지만, 내부 처리 아키텍처와 추론 방식에서 뚜렷한 차이를 보입니다.
- 언어별 체크포인트 라우팅: 추론 직전 순수 파이썬 라우터가 입력 언어를 감지하여 영어 전용 또는 다국어(Multilingual) 체크포인트를 자동으로 선택합니다.
[MASK]마커 시퀀스 생성: 각 질문마다 가능한 모든 선택지에[MASK]마커를 부여하고, 질문 및 비정형 상태 컨텍스트와 결합하여 선택지 비교를 위한 시퀀스를 구성합니다.- 스코어링 및 확률 분포 산출: 토큰 단위 자기회귀(Autoregressive) 생성 과정을 완전히 배제하고, 양방향 인코더(Bidirectional Encoder)와 경량 의사결정 헤드(Decision Head)를 통해 각 선택지별 점수를 직접 산출한 뒤 Softmax 함수로 확률 분포를 도출합니다.
- 질문 배치 평가: 여러 질문을 단일 모델 호출로 묶어 배치 처리합니다. 단, 각 질문마다 비정형 상태 데이터의 복사본이 인코더에 함께 전달됩니다.
35ms 추론 벤치마크와 온프레미스 인프라 이점
토큰 단위 텍스트 생성 루프와 외부 네트워크 왕복 지연을 제거함으로써 Laya는 실시간 추론 속도 면에서 큰 폭의 향상을 달성했습니다.
독립 테스트 환경 기준, 네트워크를 경유하는 Jev API 호출이 약 380ms를 기록한 반면, 로컬 GPU 환경에서 구동된 Laya는 약 35ms의 추론 지연 시간을 기록했습니다.
아울러 건당 API 호출 비용이 발생하지 않으며, 구형 GPU 인프라에서도 로컬 구동이 가능해 민감한 내부 데이터를 외부 클라우드로 전송하지 않고 온프레미스 환경에 온전히 유지할 수 있습니다.
제로샷 범용 모델 vs 도메인 특화 미세조정(Fine-tuning)
Laya는 모든 워크로드에서 Jev를 즉시 대체할 수 있는 드롭인(Drop-in) 솔루션은 아닙니다. 두 시스템의 최적 활용 영역은 다음과 같이 구분됩니다.
- Jev (호스팅 범용 모델): 닫힌 구조의 독자 아키텍처로 최대 255개의 선택지를 지원하며, 별도의 학습 없이 즉시 투입 가능한 강력한 제로샷(Zero-shot) 의사결정 능력을 제공합니다.
- Laya (로컬 특화 베이스): 고정된 선택지 세트와 도메인 대표 학습 데이터가 확보된 환경에 최적화되어 있습니다. 작업 특화 미세조정(Fine-tuning)과 별도 검증셋을 통한 확률 보정(Calibration)을 거칠 때 최대의 효율을 발휘합니다.
프로덕션 배치 환경에서는 모든 질문마다 비정형 상태가 복제되어 인코더로 전달되므로 동시 요청량이 급증할 때 메모리 사용량이 크게 증가할 수 있습니다. 따라서 안정적인 선택지 셋을 정의하고, Laya의 판단 확률이 임계값 이하로 떨어지는 불확실한 케이스는 상위 LLM이나 인간 검토자로 에스컬레이션하는 파이프라인 설계가 권장됩니다.
출처
- Akshay Pachaar (@akshay_pachaar) X: A faster, 100% open-source alternative to Jev: Laya