거대 LLM의 비용과 탈선을 막는 Jev 기반 10단계 에이전트 제어 시스템 구축 가이드
Claude, Codex 등 생성형 LLM 앞에 경량 결정 모델 Jev를 배치해 불필요한 토큰 소모를 줄이고, 확신도 기반 라우팅과 결정 영수증 기록으로 제어 가능한 에이전트를 구축하는 10단계 아키텍처 청사진입니다.
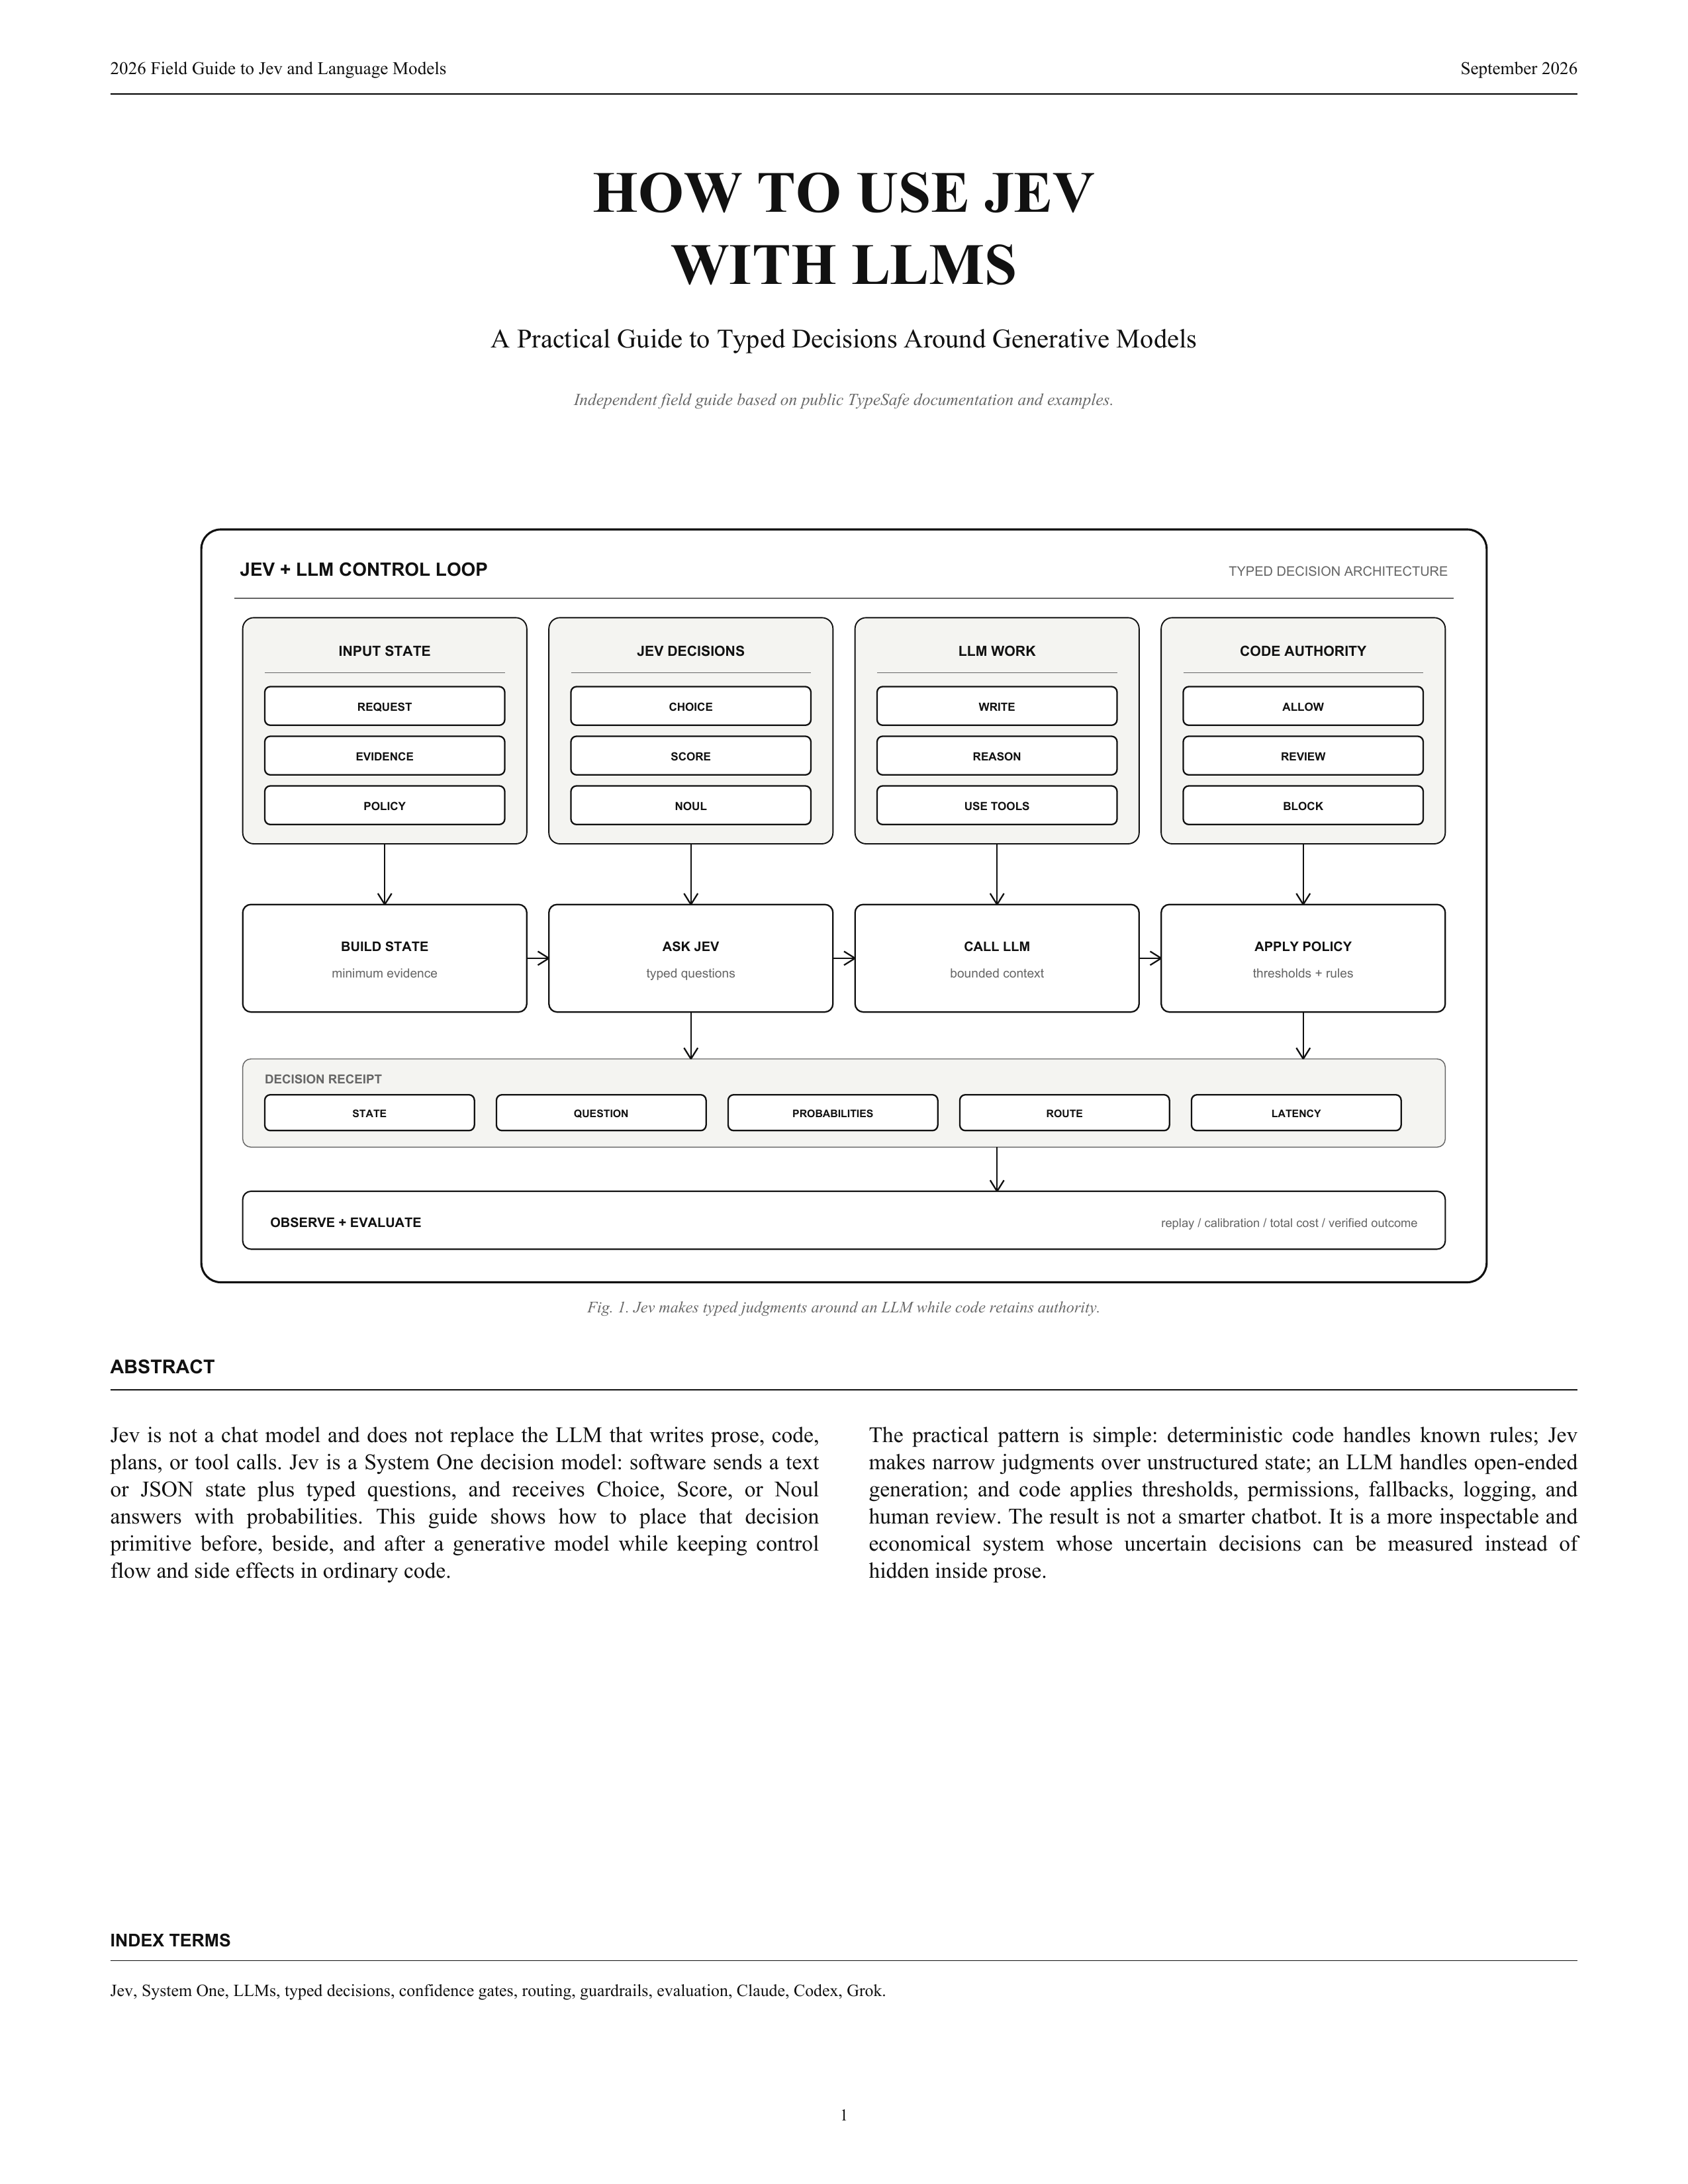
Jev의 창립자 디오고 알메이다(Diogo Almeida)가 대형 언어 모델(LLM)과 경량 결정 모델 Jev를 결합해 빠르고 비용 효율적이며 안전하게 제어 가능한 AI 시스템을 구축하는 12페이지 분량의 공식 가이드를 공개했습니다. AI 개발자 @0xwhrrari가 Claude, Codex, Grok 등 다양한 생성형 모델 환경에서 실전에 즉시 적용할 수 있도록 요약·공유한 10단계 아키텍처 구축 청사진을 상세히 정리합니다.
이미지 출처: @0xwhrrari / X
기존의 많은 AI 튜토리얼은 에이전트의 판단력을 높이기 위해 프롬프트 길이를 계속 늘리거나 대화 이력 전체를 매번 모델에 주입하는 방식을 권장합니다. 하지만 이 접근법은 토큰 비용을 급증시키고 지연 시간(latency)을 악화시킬 뿐만 아니라, 모델의 환각과 탈선 위험을 방지하기 어렵습니다. 이번 가이드의 핵심은 거대 모델에게 모든 판단을 맡기는 대신, 시스템 1(System 1) 수준의 경량 결정 모델과 결정론적 코드로 엄격한 제어 레이어를 감싸는 것입니다.
1. 역할 분리와 상태 구축, 적절한 결정 프리미티브 선택 (1~3단계)
제어 가능한 시스템을 만드는 첫걸음은 거대 생성 모델과 규칙 기반 코드, 그리고 경량 결정 엔진의 경계를 명확히 분리하는 데서 출발합니다.
- 1단계: 책임 분리 (Split the responsibilities)
- 대형 언어 모델(LLM)은 오직 자연스러운 텍스트 생성 작업만 전담합니다.
- 경로 분류, 유효성 검증, 범위 판정과 같은 제한된 의미론적 판단(bounded semantic decisions)은 경량 결정 모델인 Jev에 위임합니다.
- 최종 실행 권한과 정책 강제는 하드코딩된 결정론적(deterministic) 코드가 유지합니다.
- 2단계: 최소 상태 구축 (Build the state)
- LLM과의 누적된 전체 대화 기록을 Jev에 그대로 넘기지 않습니다.
- 현재 들어온 단일 요청(current request), 해당 작업과 직접 관련된 증거(relevant evidence), 적용할 시스템 정책(policy), 제안된 작업(proposed action)만을 추출해 경량화된 상태 객체로 구성합니다.
- 3단계: 적합한 프리미티브 선택 (Choose the right primitive)
- 작업의 성격에 맞춰 Jev의 세 가지 핵심 프리미티브를 정확히 매핑합니다.
- Choice: 가능한 여러 경로 중 가장 적합한 라우트를 단일 선택할 때 사용합니다.
- Score: 정의된 루브릭(기준표)에 따라 우선순위나 품질 척도를 평가할 때 사용합니다.
- Noul: 특정 명제나 조건이 참(true)일 확률을 0.0~1.0 사이의 확신도로 측정할 때 사용합니다.
2. LLM 호출 전후의 원자적 평가와 범위 제한 (4~7단계)
거대 LLM을 무작정 호출하기 전과 응답을 반환받은 직후에 경량 평가 레이어를 배치함으로써 비용과 실패율을 극적으로 낮출 수 있습니다.
- 4단계: 거대 평가 프롬프트를 원자적 질문으로 분할 (Replace giant evaluation prompts with atomic questions)
- 복잡한 다기준 평가를 하나의 긴 프롬프트로 처리하려 하지 않습니다.
- 사용자의 의도(intent), 처리의 시급성(urgency), 제공된 증거의 충분성(evidence), 잠재적 위험도(risk), 작업 허용 범위(scope)를 각각 독립된 타입의 단일 판단 단위로 분해해 측정합니다.
- 5단계: LLM 호출 이전에 Jev 배치 (Put Jev before the LLM)
- 수천~수만 토큰의 비싼 생성 API를 호출하기 전에 Jev를 먼저 실행합니다.
- 입력 요청에 필요한 컨텍스트, 활성화할 도구(tools), 사용할 공급자(provider), 실행할 워크플로우를 사전에 정밀 판별하여 불필요한 고비용 호출을 원천 차단합니다.
- 6단계: LLM에 명확히 제한된 작업 부여 (Give the LLM a bounded job)
- Jev가 라우팅 분기를 선택하고 나면, LLM에는 전체 시스템 프롬프트가 아니라 해당 브랜치에 필수적인 지침, 파일, 도구 권한만을 한정해 전달합니다.
- 컨텍스트 오염을 방지하고 프롬프트 길이를 대폭 줄여 응답 속도와 일관성을 동시에 개선합니다.
- 7단계: LLM 생성 직후 Jev 사후 검증 (Put Jev after the LLM)
- LLM이 출력한 생성물이 초기 요청에 충실히 답했는지, 충분한 근거를 활용했는지, 허용된 작업 범위를 벗어나지 않았는지 Jev로 즉시 검증합니다.
- 환각이나 규칙 위반이 감지되면 사용자에게 노출되기 전 안전한 폴백을 실행합니다.
3. 확신도 기반 라우팅과 배치 처리, 결정 영수증 기록 (8~10단계)
시스템의 신뢰성과 장기적 유지보수성을 보장하기 위해 확률적 확신도를 바탕으로 실행 경로를 분기하고 모든 결정 내역을 영구 감사 데이터로 보존합니다.
- 8단계: 확신도 기반 조건부 라우팅 (Route by confidence)
- 높은 확신도(high confidence)와 낮은 위험도를 가진 요청은 추가 검증 없이 자율적으로 자동 처리합니다.
- 확신도가 애매한 케이스는 사용자에게 추가 맥락을 재요청하고, 파괴적이거나 결과가 큰(consequential) 작업은 관리자 승인 단계로 전달합니다.
- 9단계: 독립된 결정들의 배치 처리 (Batch independent decisions)
- 판단이 필요한 항목마다 LLM을 매번 따로 부르는 대신, 단일 상태 객체 위에서 여러 개의 Choice, Score, Noul 질문을 한 번에 병렬 배치로 평가합니다.
- 네트워크 왕복 지연 시간과 처리 비용을 최소화합니다.
- 10단계: 완전한 결정 영수증 보존 (Record the complete decision receipt)
- 시스템에서 일어난 모든 판단에 대해 상태 버전(state version), 질문 내용, 확률값 분포, 선택된 라우트, 사용된 모델, 지연 시간, 최종 결과, 인간 개입(override) 여부를 '결정 영수증' 형태로 기록합니다.
- 추후 에이전트의 실패 원인 진단과 모델 평가, 시스템 디버깅을 데이터 기반으로 완벽히 추적할 수 있습니다.
대부분의 AI 강좌는 프롬프트를 길고 장황하게 작성하는 요령에 집중하지만, 프로덕션 환경에서 가장 절실한 것은 프롬프트 바깥을 단단하게 감싸는 제어 아키텍처입니다. 10단계 제어 모델을 도입하면 LLM 에이전트의 운영 비용을 획기적으로 절감하면서도 예측 가능한 신뢰성을 확보할 수 있습니다.
원문 출처
- X(Twitter) 스레드 요약: @0xwhrrari 원문 게시물
- Diogo Almeida 공식 가이드 PDF: Google Drive 원문 문서 (12-Page Guide)