Heretic: 재학습 없이 언어 모델의 검열과 슬롭을 제거하는 오픈소스 CLI 도구
별도 파인튜닝 없이 수학적 가중치 절제 기법(ARA 및 Abliteration)과 Optuna 최적화로 언어 모델의 거부 반응, 아첨, 상투적 표현을 제어하는 오픈소스 도구 Heretic v2.1의 구조와 사용법을 살펴봅니다.
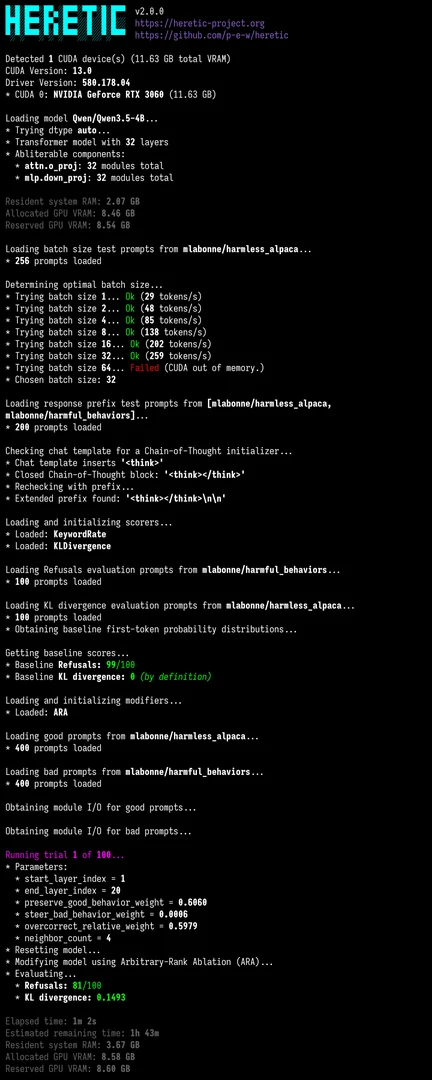
대규모 언어 모델(LLM)의 응답 성향을 바꾸거나 과도한 안전장치로 인한 거부 반응을 해제하려면 막대한 연산 자원과 데이터셋을 들여 파인튜닝(Fine-tuning, 추가 미세조정 학습)을 거치는 것이 일반적이었습니다. 오픈소스 프로젝트 Heretic(저자: p-e-w)은 모델 파라미터를 다시 학습시키는 대신, 가중치 행렬에서 특정 행동을 유발하는 방향 벡터를 수학적으로 제거하거나 억제하는 방식으로 개인 PC 환경에서도 모델의 성향을 단시간에 교정할 수 있도록 구현된 오픈소스 명령줄 도구(CLI)입니다.
이미지 출처: p-e-w/heretic (GitHub README)
Heretic은 2026년 11월 8일 최신 안정화 버전인 v2.1.0을 공개했으며, GitHub 저장소 기준 4만 400개 이상의 스타와 4,600여 건의 포크를 기록하며 오픈소스 AI 커뮤니티에서 기술적 관심을 받고 있습니다. 프로젝트는 GNU AGPLv3 라이선스로 배포됩니다.
대조 프롬프트와 옵튜나 기반 최적화 엔진의 결합
Heretic의 핵심은 모델 전체를 역전파(Backpropagation)로 훈련하지 않는다는 점입니다. 대신 '대조 프롬프트(Contrasting example prompts)'와 출력 품질을 평가하는 '스코어러(Scorer)' 플러그인, 그리고 하이퍼파라미터 최적화 라이브러리인 옵튜나(Optuna)의 TPE(Tree-structured Parzen Estimator) 알고리즘을 결합해 동작합니다.
작동 원리를 살펴보면, 시스템은 먼저 특정 행동(예: 유해하지 않은 민감 질문에 대한 무조건적 답변 거부)을 유도하는 프롬프트와 정상 응답 프롬프트를 비교해 모델 내부 활성화(Activation) 상태의 차이를 추적합니다. 이후 모델 변형 모듈인 모디파이어(Modifier)가 모델의 가중치 레이어에 개입하며, 옵튜나 탐색기가 스코어러 플러그인이 측정한 점수를 극대화하거나 최소화하는 최적의 변형 강도 매개변수를 찾아냅니다.
기본 탑재된 모디파이어는 두 가지입니다.
- 임의 순위 절제(Arbitrary-Rank Ablation, ARA): Heretic 프로젝트를 위해 개발된 기본 변형 방식으로, 가중치 텐서의 특정 랭크 영역을 정밀하게 교정합니다.
- 방향성 제거(Directional Ablation, 일명 Abliteration): 연구진(Arditi et al., 2024)이 제안한 거부 방향 벡터 제거 기법으로, 레이어별 유연한 절제 가중치 커널과 투영 절제(Projected abliteration), 노름 보존(MPOA) 방식을 지원합니다.
기존의 단순 절제 스크립트들이 특정 레이어에 일괄적인 연산을 가해 모델의 일반 추론 지능까지 훼손하던 문제와 달리, Heretic은 쿨백-라이블러 발산(KL Divergence, 원본 모델과 변형 모델 간 확률 분포 차이를 측정하는 지표) 스코어러를 함께 co-optimization(동시 최적화) 지표로 삼아 일반 지식 보존과 목표 성향 제거 사이의 균형점을 자동으로 탐색합니다.
설정 파일로 선택하는 모델 교정 프리셋
Heretic은 기본 설정(config.default.toml) 상태에서 실행할 경우 '거부 반응 억제(검열 제거)'를 수행합니다. 하지만 스코어러 설정과 목적 함수를 바꾼 다양한 공식 설정 파일(TOML)을 함께 제공하여 모델의 여러 동작 특성을 제어할 수 있습니다.
- 슬롭 감소(
config.noslop.toml): AI 특유의 상투적이고 공허한 미사여구나 불필요한 서두 표현(Slop)을 억제합니다. - 아첨 완화(
config.nosyco.toml): 사용자의 틀린 전제나 유도 질문에 무비판적으로 동조하는 아첨(Sycophancy) 성향을 줄입니다. - 유머 억제(
config.nohumor.toml): 불필요한 농담이나 가벼운 톤을 배제하고 직설적인 답변을 유도합니다. - 감정 정렬 변경(
config.emotions.toml): 모델 응답 톤의 감정적 기조를 재조정합니다. - 간결한 응답(
config.terse.toml): 군더더기 설명을 줄이고 핵심 결론 위주로 출력 길이를 단축합니다.
사용자는 파이썬의 Scorer 추상 기본 클래스를 상속받아 사용자 정의 스코어러 플러그인을 직접 작성할 수도 있습니다. get_score 메서드만 구현하면 별도의 패키지 수정 없이 파일 경로(path/to/plugin.py:MyClass) 지정만으로 사용자 정의 목표에 맞춘 모델 변형을 유도할 수 있습니다.
설치 경로와 실무 구동 요구 사항
Heretic은 Python 3.10 이상 및 PyTorch 2.6 이상이 설치된 환경에서 구동됩니다. 공식 패키지는 PyPI를 통해 배포되므로 pip 명령으로 바로 설치할 수 있습니다.
pip install -U heretic-llm
heretic Qwen/Qwen3-4B-Instruct-2507
명령어를 실행하면 대상 모델의 가중치를 다운로드하거나 불러온 뒤 하드웨어 사양을 벤치마크하여 최적의 배치 크기를 자동으로 결정합니다. 처리 작업이 완료되면 결과 모델 저장, 허깅페이스(Hugging Face) 허브 업로드, 내장 대화 인터페이스를 통한 성능 확인, 표준 벤치마크 평가를 순차적으로 진행할 수 있습니다.
작업에 필요한 하드웨어 자원과 실행 시간은 다음과 같습니다.
- 소비자용 GPU 구동 및 양자화: 설정 파일 내에
quantization = "bnb_4bit"옵션을 지정하면 bitsandbytes 라이브러리를 통해 실시간 4비트 양자화가 적용됩니다. 약간의 정밀도 손실이 발생할 수 있지만, 일반적인 4비트 양자화 모델을 추론할 수 있는 수준의 VRAM만으로도 대형 모델 변형 처리가 가능해집니다. - 소요 시간 기준: 엔비디아 지포스 RTX 3090 단일 GPU 환경에서 기본 설정을 사용해 Qwen3-4B-Instruct-2507 모델을 처리할 경우 약 30분에서 40분이 소요됩니다.
재현 매니페스트 관리와 버전 호환성 유의점
모델 가중치를 직접 미세조정하는 딥러닝 프레임워크는 드라이버 버전, 운영체제, 라이브러리 차이에 따라 동일한 계산 결과가 나오지 않는 비결정론적 특성을 보이기 쉽습니다. Heretic은 이를 해결하기 위해 변형 작업 완료 후 모델 저장소에 9KB 내외의 재현 매니페스트(reproduce.json)와 안내 문서를 생성합니다.
이후 다른 환경이나 타인이 동일한 모델 가중치를 복원하고자 할 때는 아래 명령을 실행하면 됩니다.
heretic --reproduce path/to/reproduce.json
Heretic은 현재 환경의 의존성 패키지와 하드웨어 구성을 매니페스트와 대조 검증하며 동일한 변형 결과를 자동으로 재현합니다.
도구 사용 시 확인해야 할 제약 사항도 존재합니다. Heretic 1.x 시리즈에서 작성된 TOML 설정 파일은 2.x 아키텍처와 구문 호환이 되지 않으므로 저장소 내 마이그레이션 문서(docs/migration_v1_to_v2.md)를 참조해 설정을 갱신해야 합니다. 또한 복수의 모디파이어를 동시에 체이닝하는 기능은 현재 버전에서 지원되지 않으며, 단일 실행당 하나의 모디파이어(ARA 또는 Abliteration)만 활성화할 수 있습니다.
출처
- GitHub 저장소: p-e-w/heretic
- 프로젝트 공식 웹사이트: Heretic Project
- Hugging Face 조직 저장소: Heretic Org