하버드 CS249r 기반 머신러닝 시스템 오픈소스 교재 및 TinyTorch 실습 가이드 공개
하버드 CS249r 강의를 바탕으로 분산 학습 확장, KV 캐시 메모리 최적화, 지연시간·처리량 절충, 엣지 기기 배포를 다루는 머신러닝 시스템 오픈소스 교재와 20개 모듈의 TinyTorch 실습 프레임워크가 공개되었습니다.
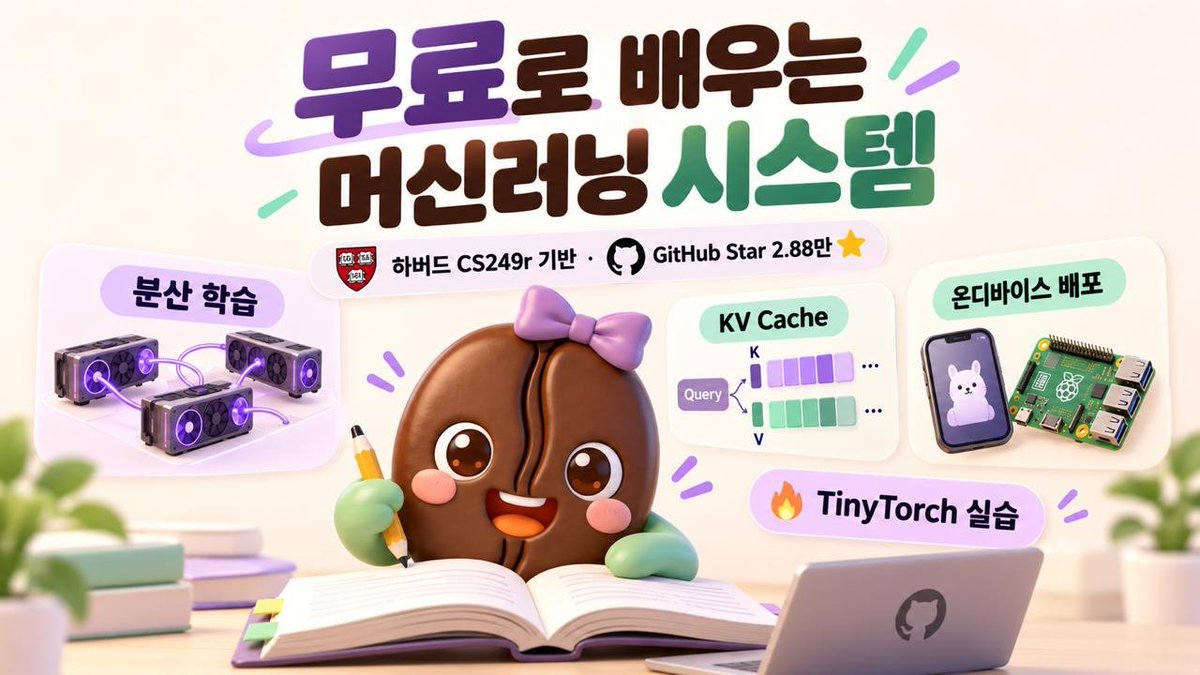
하버드 대학교 CS249r 강의를 바탕으로 제작된 오픈소스 머신러닝 시스템 교재 'Machine Learning Systems'와 실습 프로젝트 'TinyTorch'가 GitHub에 공개되어 누구나 무료로 열람하고 실습할 수 있게 되었습니다. 이번 교재는 GitHub 스타 2.88만 개를 기록하며 실제 프로덕션 서비스와 제한된 하드웨어 환경에서 AI 모델을 운영할 때 직면하는 핵심 엔지니어링 문제를 체계적으로 다룹니다.
이미지 출처: @AI_Caffeine / Harvard CS249r
원작성자인 @AI_Caffeine이 정리한 핵심 커리큘럼과 실습 프레임워크 구성을 바탕으로 주요 내용과 실습 가이드를 소개합니다.
머신러닝 시스템(ML Systems) 핵심 커리큘럼
교재 1권에서는 모델의 학습 확장부터 엣지 기기 배포까지 실제 시스템 엔지니어링 관점의 필수 주제들을 포괄합니다.
- 다중 GPU 분산 학습: 여러 GPU로 학습을 효율적으로 확장(Scaling)하는 분산 아키텍처와 통신 최적화 원리를 설명합니다.
- 추론 시 KV 캐시(KV Cache) 메모리 점유: LLM 생성 추론 과정에서 KV 캐시가 메모리를 과도하게 점유하는 구조적 원인을 분석하고 최적화 방안을 제시합니다.
- 지연 시간·처리량·비용 절충(Trade-off): Latency(지연 시간), Throughput(처리량), 인프라 비용 간의 상충 관계를 정량적으로 계산하고 서비스 요구사항에 맞춰 튜닝하는 방법을 다룹니다.
- 자원 제한 기기(엣지/임베디드) 배포: 스마트폰이나 라즈베리 파이(Raspberry Pi)처럼 연산 자원과 메모리가 제한된 환경에 모델을 경량화하여 배포하는 실무 기법을 다룹니다.
20개 모듈로 완성하는 'TinyTorch' 프레임워크 실습
이론 학습과 함께 제공되는 'TinyTorch'는 머신러닝 프레임워크를 밑바닥부터 직접 구현해보는 20개 모듈 단위의 실습 프로젝트입니다.
- 단계별 프레임워크 구현: 텐서 연산부터 자동 미분(Autograd), 신경망 레이어, 옵티마이저까지 20개 모듈을 순차적으로 직접 코딩하며 프레임워크 내부 동작 원리를 체득합니다.
- 인터랙티브 실험 환경: 매개변수(Hyperparameter)를 변경하며 결과를 즉시 시각적으로 검증할 수 있는 인터랙티브 실험 도구를 제공합니다.
- 하드웨어 및 병목 시뮬레이터: 실제 하드웨어 대상 실습과 함께, 메모리 대역폭 및 네트워크 통신 병목을 사전에 계산하고 분석해볼 수 있는 하드웨어 시뮬레이터가 포함되어 있습니다.
학습 요구사항 및 로드맵 안내
이 교재와 실습 프로젝트는 기초 프로그래밍과 머신러닝 개념을 이미 익힌 엔지니어가 시스템 엔지니어링 심화 단계로 나아가는 데 최적화되어 있습니다.
- 선행 지식: Python 프로그래밍 및 기본적인 머신러닝/딥러닝 기초 개념을 선행 학습한 후 진행하는 것을 권장합니다.
- 후속 권 로드맵: 에이전트의 기억(Memory), 도구 호출(Tool Calling), 다중 에이전트(Multi-agent) 협업, 로보틱스(Robotics) 등을 다루는 후속 권은 현재 개발 진행 중입니다.
원문 출처
- 원작성자: @AI_Caffeine
- 온라인 교재: Machine Learning Systems Book
- GitHub 저장소: Machine Learning Systems & TinyTorch Repository