딥시크, V4.1-Flash 지원 추론 프레임워크 DeepInfer 오픈소스 공개
딥시크가 자사 프로덕션 서비스에 사용하는 추론 프레임워크 DeepInfer를 오픈소스로 공개했습니다. 이번 공개 구현은 V4.1-Flash를 지원하며 오프라인 추론에 집중합니다.
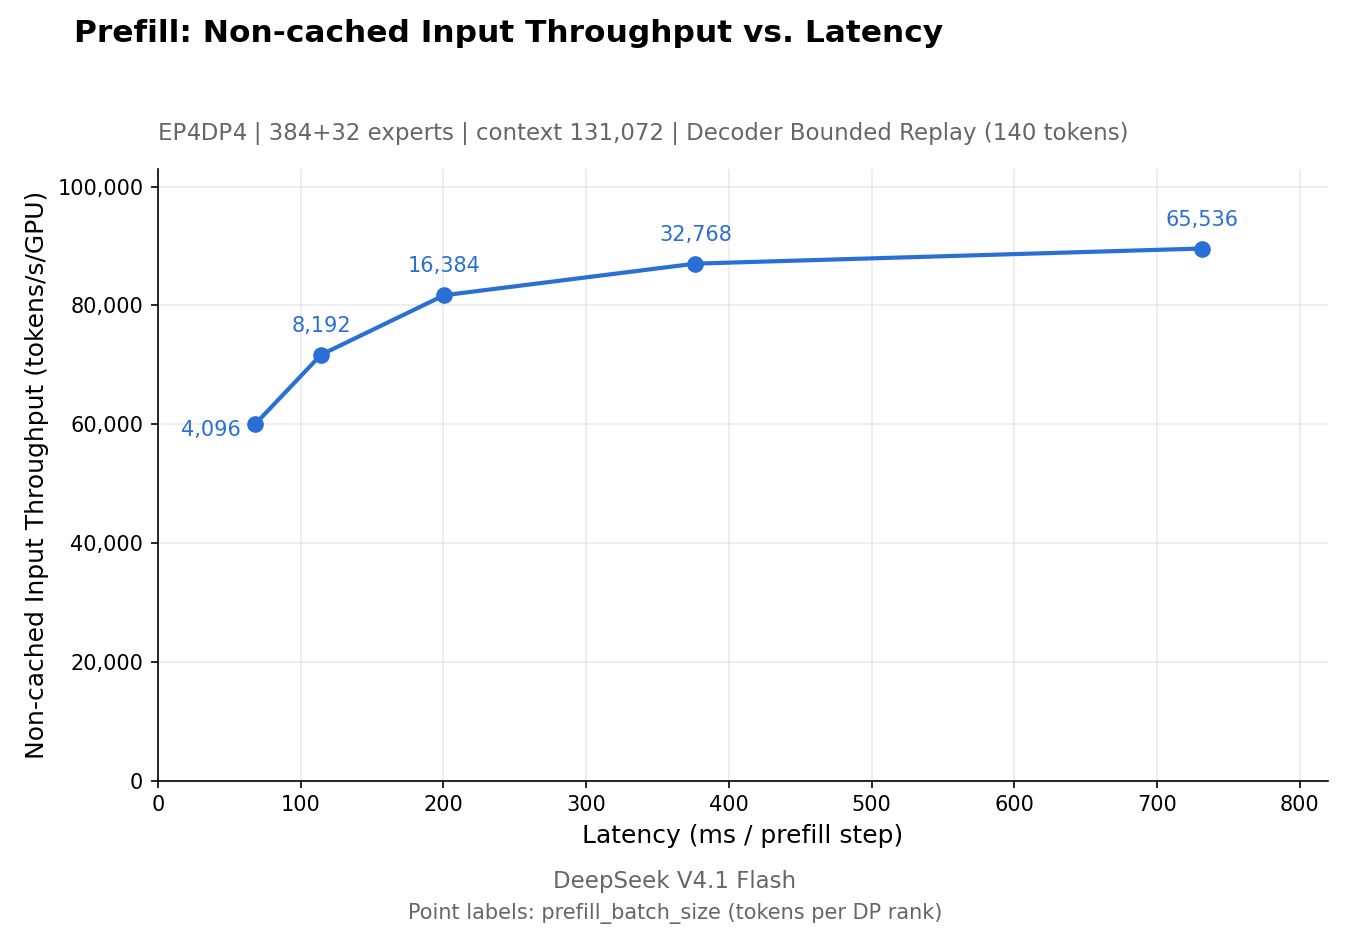
이미지: DeepInfer 공식 저장소의 프리필 성능 그래프(doc/images/prefill_pareto.png).
대규모 프로덕션을 지탱하는 DeepInfer 오픈소스 공개
딥시크(DeepSeek)가 자사의 대규모 프로덕션 서비스에 사용하는 고성능 추론 프레임워크 'DeepInfer'를 아파치 2.0 라이선스로 오픈소스 공개했습니다. 이번 공개 릴리스는 대규모 서빙에 필요한 핵심 기능을 갖춘 오프라인 추론 환경을 제공하며, 깃허브 deepseek-ai/DeepInfer 저장소를 통해 코드가 배포되었습니다. 공개된 지원 모델 목록에는 DeepSeek-V4.1-Flash가 포함됩니다. 또한 프로젝트 감사의 글(Acknowledgments)을 통해 DeepInfer가 원래 주로 vLLM을 기반으로 구축되었으며, SGLang과 TensorRT-LLM으로부터 추가적인 영감을 받았음을 명시했습니다.
고효율 분산 병렬화와 특화 최적화 커널
DeepInfer는 대규모 분산 추론을 위해 다양한 병렬 처리 기술과 최적화 커널을 통합했습니다. 어텐션 데이터 병렬화(Attention DP), 균형 잡힌 컨텍스트 병렬화(balanced CP), MoE 전문가 병렬화(MoE EP) 및 부하 분산(EPLB)을 지원하여 대형 모델 연산을 분산합니다. 또한 FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect 및 커스텀 TileLang 커널을 통합했습니다. 디코딩 가속을 위해 드래프트 토큰과 신뢰도 추정치를 사용하는 DSpark 및 신뢰도 스케줄링 검증을 제공하며, 프리필 연산 부담을 덜어주는 SWA 유계 리플레이 기술을 통해 한정된 접미사만 재생하도록 지원합니다. 아울러 제로 오버헤드 비동기 배치 스케줄러가 기본 활성화되어 있고, 엔비디아 환경에서는 배치 불변 추론과 결정론적 샘플링을 제공하며 구조화된 출력 기능은 정규식, JSON 스키마, EBNF 문법 제약까지 폭넓게 지원합니다.
오프라인 추론 중심 공개와 완전한 서비스 구축 시 고려사항
이번 공개 릴리스는 대규모 서빙에 필요한 핵심 기능을 제공하지만 현재 구현은 오프라인 추론(offline inference)에 중점을 두고 있습니다. 지원 모델 목록에는 DeepSeek-V4.1-Flash가 있으며, 기본 체크포인트는 deepseek-ai/DeepSeek-V4.1-Flash-1017입니다. 첫 실행 시 허깅페이스 캐시로 모델을 내려받으며 환경 변수로 로컬 경로를 지정할 수도 있습니다. 지원 하드웨어는 엔비디아 SM100 GPU(CUDA 13)와 화웨이 어센드 950 NPU(CANN 9.2)이며, 리눅스, 파이썬 3.12, GCC 13.0 이상이 요구됩니다. 완전한 상용 서비스를 구축하려면 이번 릴리스에 미포함된 KV 캐시 시스템, 프리필·디코딩 분리(VE/Prefill/Decode disaggregation) 인프라, 그리고 프리필과 디코딩 데이터 병렬 레플리카 간 부하 분산 레이어를 별도로 구성해야 합니다.