코딩 몰라도 만드는 쇼츠 자동화… Claude Code·Gemini 기반 9단계 파이프라인 구축법
Claude Code와 Codex를 활용해 영상 컷 분할부터 Gemini 사실 추출, TTS 음성 합성, ffmpeg 렌더링, FastAPI 검수 웹 화면까지 쇼츠 자동화 프로그램을 직접 만드는 9단계 가이드와 핵심 프롬프트입니다.
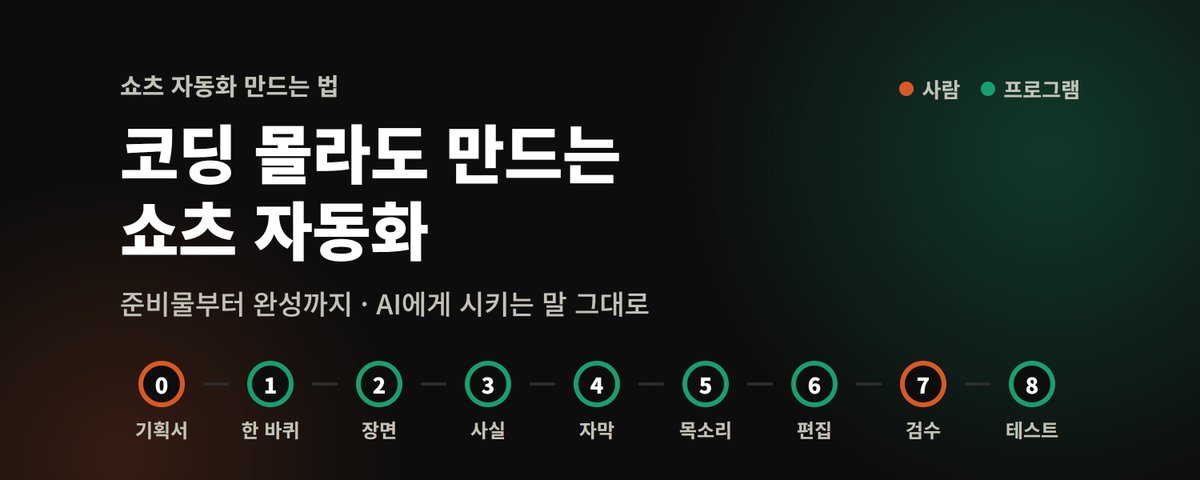
AI 크리에이터 @Che0dan이 프로그래밍 개발 경험이 없는 사용자도 Claude Code와 Codex 같은 AI 코딩 도구를 활용해 유튜브 쇼츠(Shorts) 제작 전 과정을 자동화할 수 있는 '9단계 쇼츠 자동화 파이프라인' 구축 가이드를 공개했습니다.
이미지 출처: @Che0dan via X
이번 가이드는 단순 일회성 프롬프트 작성에 머무르지 않고, 기획부터 컷 편집, 메타데이터 추출, 다중 대본 작성, 음성 합성, 로컬 렌더링, 그리고 최종 웹 검수 대시보드에 이르는 엔드투엔드(End-to-End) 소프트웨어를 '바이브 코딩(Vibe Coding)' 방식으로 직접 완성할 수 있는 체계적인 로드맵을 제시합니다.
핵심 아키텍처: 4단계 구조와 AI 도구 스택
파이프라인의 전체 워크플로우는 데이터의 흐름에 따라 명확한 4대 핵심 구조로 설계되었습니다.
- 읽기(Read): 원본 영상을 분석해 장면(Scene) 단위로 분할하고 각 구간의 시각적 특징과 타임코드를 기록합니다.
- 쓰기(Write): 원본 설명글에서 검증 가능한 사실(Fact)만을 추출한 뒤, 이를 바탕으로 제목, 자막, 3가지 유형(A/B/C형)의 대본을 작성합니다.
- 만들기(Make): TTS 모델을 통해 대사를 고음질 오디오로 변환하고, 로컬 ffmpeg 엔진으로 영상 클립과 자막, 음성을 결합해 1080x1920 세로형 쇼츠 3종을 렌더링합니다.
- 확인하기(Verify): FastAPI 기반 브라우저 대시보드에서 작업자가 생성된 3가지 결과물을 직접 시청하고 최종 승인 여부를 결정합니다.
이 과정에 투입되는 최신 AI 모델 및 인프라 스택은 다음과 같습니다.
- 개발 및 바이브 코딩: Claude 5.5 Opus, Claude 5.5 Sonnet, OpenAI Codex
- 정보 추출 및 음성 합성: Google Gemini 3.8 Flash, Gemini 3.8 Flash TTS (로컬 대안: Supertonic-3, Qwen3-TTS)
- 보조 검수 엔진: Cloudflare Workers AI 기반 Clef-omni (Jev 규격 호환 판단 모델, 100만 입력 토큰당 0.15달러)
- 로컬 미디어 프로세싱: Python, PySceneDetect, ffmpeg, FastAPI
9단계 구축 프로세스 (단계 0 ~ 단계 8)
@Che0dan이 정리한 단계별 구축 과정은 프로젝트의 뼈대를 세우는 것부터 안전장치를 더하는 것까지 점진적으로 진행됩니다.
단계 0: 기획서 작성 및 Git 환경 설정
개발을 시작하기 전, AI 코딩 에이전트에게 전체 프로젝트의 요구사항과 구조를 담은 PLAN.md 문서를 작성하도록 지시합니다. 이어 버전 관리 중 민감 정보나 대용량 파일이 유출되지 않도록 .gitignore 파일에 .env, .venv, input/, output/, data/, models/, backup/ 경로를 추가하고 초기 커밋을 생성합니다.
단계 1: 기본 파이프라인 최소 동작 확인
Python과 로컬 시스템에 설치된 ffmpeg 환경을 연동하여, input/ 폴더에 넣은 원본 영상(input/원본.mp4)의 앞 30초 구간을 1080x1920 해상도, 30fps, H.264 코덱의 세로형 영상(output/step1.mp4)으로 정상 크롭 및 렌더링하는 최소 단위 파이프라인을 먼저 검증합니다.
단계 2: PySceneDetect 기반 영상 장면 분할
PySceneDetect 라이브러리를 활용해 영상의 화면 전환을 자동으로 감지하고 장면별로 분할합니다. 각 장면의 대표 프레임 2장을 정지 이미지로 추출하며, 장면별 시작·종료 타임코드와 메타데이터를 scenes.json 파일에 체계적으로 기록합니다.
단계 3: Gemini 기반 사실 추출 및 원문 검증
Gemini API를 호출해 영상과 연관된 설명글이나 스크립트에서 주제별 핵심 메타데이터를 추출합니다. 이때 환각(Hallucination)을 방지하기 위해 엄격한 코드 검증기를 두어 원문 근거(evidence)가 확인된 항목만 data/facts.json에 저장하며, 근거가 부족한 정보는 임의 생성을 차단하고 '확인 필요' 플래그를 부여합니다.
단계 4: 3가지 스타일 대본 자동 생성
검증된 data/facts.json 데이터를 기반으로 성격이 다른 세 가지 유형의 쇼츠 대본을 동시에 생성합니다.
- A형 (자막 중심형): 빠른 정보 전달과 시각적 텍스트 자막에 집중한 구성
- B형 (반전 훅형): 강렬한 도입부 훅(Hook)과 차별화된 전개 방식을 채택한 구성
- C형 (해설 스토리텔링형): 차분한 설명과 서사적 맥락을 강조한 해설형 구성
단계 5: TTS 음성 합성 및 STT 역검증
생성된 대사를 Gemini 3.8 Flash TTS 또는 로컬 TTS(Supertonic-3, Qwen3-TTS)로 전달해 음성 파일로 변환한 뒤 audio/ 디렉토리에 저장합니다. 음성 누락이나 왜곡을 잡기 위해 STT(Speech-to-Text) 모델로 해당 오디오를 다시 텍스트로 풀어낸 뒤 원본 대본과 대조 검증하는 단계를 거칩니다.
단계 6: 로컬 ffmpeg 합성 및 프레임 규격 검사
추출된 영상 장면, 자막, 합성된 TTS 음성을 로컬 ffmpeg 명령어로 결합합니다. A/B/C형 대본에 맞춘 1080x1920 세로 영상 3개를 최종 렌더링하고, 완성된 파일의 프레임 이상 여부를 검사합니다.
단계 7: FastAPI 기반 검수 웹 대시보드 구축
비개발자도 직관적으로 작업할 수 있도록 FastAPI 기반의 로컬 웹 브라우저 인터페이스를 구축합니다. 브라우저 화면에서 원본 영상 파일을 업로드하고, 백그라운드 파이프라인의 진행 상황을 실시간으로 확인하며, 생성된 3종의 쇼츠 영상을 나란히 미리보기로 재생해 비교한 뒤 최종 승인 버튼을 누를 수 있도록 구성합니다.
단계 8: 예외 처리와 안전장치 강화
파이프라인이 중단 없이 안정적으로 동작하도록 운영 안전장치를 보강합니다. 프로세스 중복 실행 방지 락(Lock), 네트워크 장애 시 중단된 단계부터 이어받는 복구 로직, API 할당량 초과 핸들링, 작업 데이터 백업 및 복원 기능, 단위 테스트 코드를 추가해 완성도를 높입니다.
실무 적용 시 필수 주의사항과 비용 관리
@Che0dan은 자동화 시스템을 실제 구축하고 운영할 때 반드시 지켜야 할 몇 가지 핵심 원칙을 강조했습니다.
- API 키 관리 철칙: 유료 AI API 키는 절대로 Claude나 Codex 대화창에 직접 붙여넣지 말고, 로컬 환경의
.env파일에만 보관하며 git 커밋 대상에서 완벽히 배제해야 합니다. - 로컬 연산과 클라우드 AI의 엄격한 분리: 비디오 트랜스코딩과 자막 합성 등 무거운 미디어 작업은 사용자 PC의 ffmpeg로 로컬 처리해야 합니다. 영상 편집에 클라우드 AI 모델을 호출하면 토큰 한도가 순식간에 고갈되므로, AI는 대본 작성과 장면 분석, 사실 검증에만 한정 투입해 사용량 한도를 아끼고 안정적으로 운영할 수 있습니다.
- 원본 영상 저작권 확보: 원본 영상은 유튜브의 타인 쇼츠를 무단 도용하는 것을 지양하고, 사전 사용 허락을 취득한 영상이나 직접 촬영한 오리지널 푸티지를 원본으로 투입하는 것이 바람직합니다.
- 인간 개입 검수(Human-in-the-Loop): AI가 작성한 대본과 합성 영상은 발행 직전 단계에서 반드시 사람이 직접 눈과 귀로 시청하여 사실 왜곡이나 오탈자가 없는지 최종 승인해야 합니다.
원문 출처
- 원작자 X 스레드: @Che0dan 게시물
- 상세 아티클: X Article 원문