바이두, 100페이지 PDF를 한 번에 읽는 3B 로컬 오픈소스 'Unlimited OCR' 공개
바이두가 32k 컨텍스트와 3B 파라미터로 100페이지 분량의 PDF를 페이지 분할 없이 로컬에서 연속 분석하는 오픈소스 'Unlimited OCR'을 공개했습니다.
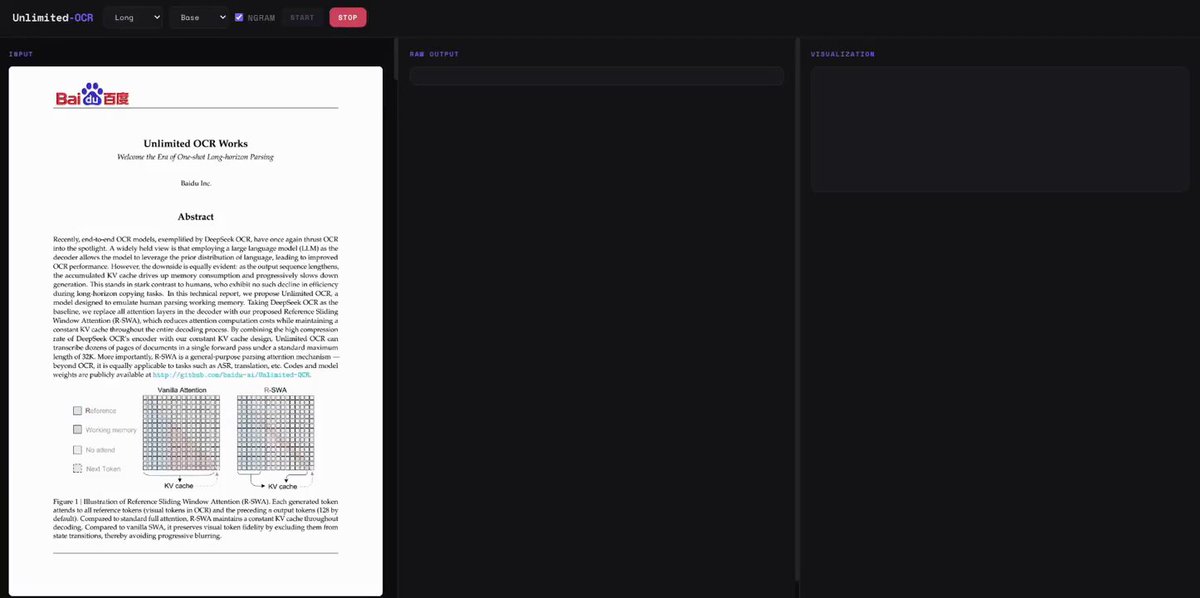
중국 바이두(Baidu)가 최대 100페이지에 달하는 대용량 PDF 문서를 중간 페이지 분할 없이 한 번에 연속 처리하는 오픈소스 OCR 모델 'Unlimited OCR'을 깃허브(GitHub: baidu/Unlimited-OCR)에 공개했습니다. 3B(30억 개) 파라미터 크기의 경량 모델로 32k 토큰 컨텍스트 윈도우를 갖추고 있으며, 외부 클라우드 API 호출 없이 사용자의 로컬 환경에서 단일 패스(Single-pass)로 전체 문서를 분석합니다.
이미지 출처: @liambraus (X)
기존 문서 파싱 및 OCR 파이프라인의 가장 큰 고질병은 수십에서 수백 페이지에 이르는 긴 문서를 개별 페이지 단위로 쪼개어 처리해야 한다는 점이었습니다. 이 방식은 두 페이지에 걸쳐 이어지는 대형 표나 복합 서식, 문맥이 페이지 경계에서 끊어지면서 구조화 데이터가 훼손되는 문제가 빈번했습니다. Unlimited OCR은 DeepSeek의 OCR 연구 성과를 한 단계 발전시켜, 전체 문서를 절단 없이 처음부터 끝까지 하나의 호흡으로 읽어내도록 설계되었습니다.
페이지 분할 없는 단일 패스 처리와 32k 컨텍스트 아키텍처
Unlimited OCR의 핵심 아키텍처 차별점은 32k 컨텍스트 윈도우를 활용해 최대 100페이지 분량의 PDF 문서를 단일 패스로 처리한다는 점입니다.
문서 전체를 단절 없이 연속으로 읽어 들이기 때문에, 기존 페이지 분할형 파이프라인에서 필연적으로 발생하던 구조적 결함들을 원천 차단합니다.
- 페이지 경계 레이아웃 보존: 여러 페이지에 걸쳐 작성된 재무제표, 비교표, 다열 문서 등 복합 레이아웃이 페이지 경계선에서 잘려나가지 않고 온전한 표 구조로 유지됩니다.
- 문서 전반의 문맥 연속성: 문단이나 문장이 다음 페이지로 넘어갈 때 발생하는 의미 단절이나 개체명 인식 누락을 방지하여 RAG(검색 증강 생성) 및 정형 데이터 추출 단계의 후처리 부담을 줄입니다.
- 파이프라인 단순화: PDF를 개별 이미지로 래스터라이징하고, 청킹(Chunking)하고, 병합하는 복잡한 전·후처리 엔지니어링 과정을 제거하여 단일 모델 추론으로 파이프라인을 간소화합니다.
벤치마크 성능과 표준 추론·컨테이너 지원 생태계
경량 3B 파라미터 체급임에도 불구하고 정밀한 문서 분석 벤치마크에서 높은 완성도를 입증했습니다.
문서 분석 벤치마크에서 93%의 처리 정확도를 기록했으며, 특히 40페이지 연속 분석 테스트 환경에서도 오류율을 0.11 미만으로 억제하며 장문 처리 안정성을 입증했습니다. 또한 다국어 처리를 기본 지원하여 다양한 언어로 구성된 문서 세트를 별도의 추가 파인튜닝 없이 즉각 파싱할 수 있습니다.
- 표준 서빙 프레임워크 지원: Hugging Face Transformers를 비롯해 고속 추론 엔진인 vLLM 및 SGLang과의 연동을 공식 지원합니다.
- 컨테이너 배포: Docker 컨테이너 환경을 제공하여 로컬 워크스테이션부터 온프레미스 프라이빗 GPU 서버 클러스터까지 표준화된 방식으로 배포할 수 있습니다.
- 상용 활용 가능한 오픈소스 라이선스: MIT 라이선스로 배포되어 연구용에 국한되지 않고 상용 제품이나 사내 문서 인프라에 라이선스 제약 없이 통합할 수 있습니다.
클라우드 API 대비 비용 구조와 하드웨어·컨텍스트 한계
클라우드 기반 OCR 서비스와 비교했을 때 Unlimited OCR은 압도적인 비용 절감 효과를 제공하지만, 자체 인프라 운용에 따른 고려사항도 명확합니다.
현재 AWS Textract, Google Cloud Vision, Azure Computer Vision 등 주요 퍼블릭 클라우드 OCR 서비스는 1,000페이지당 약 1.50달러에서 15달러 수준의 종량제 요금을 부과하고 있습니다. 대규모 아카이브 문서나 계약서 수만 건을 처리해야 하는 엔터프라이즈 환경에서 클라우드 API 누적 비용은 상당한 부담으로 작용합니다. Unlimited OCR은 모델을 로컬 머신에서 직접 구동하므로 페이지당 추가 과금 없이 자체 하드웨어로 무제한 처리가 가능합니다.
다만 실무 적용 전 확인해야 할 명확한 기술적 한계도 존재합니다.
- 고밀도 문서의 32k 컨텍스트 경계: 표, 도면, 빽빽한 수식 등이 가득 찬 고밀도 기술 문서의 경우 100페이지 전체를 처리할 때 32k 토큰 한계에 도달할 수 있어 사전 검증이 필요합니다. 바이두는 향후 128k 컨텍스트 확장 버전을 준비 중임을 언급한 바 있습니다.
- 자체 로컬 하드웨어 요구: 클라우드 API와 달리 3B 모델 추론을 안정적으로 수행할 수 있는 로컬 GPU 등 온프레미스 컴퓨팅 자원이 확보되어야 합니다.
출처
- GitHub 저장소: baidu/Unlimited-OCR
- X 기술 공개 스레드 (@liambraus): 2026-10-15 Unlimited OCR 발표 및 기술 토론