안드레이 카파시의 AI 밑바닥 구현 시리즈: micrograd부터 nn-zero-to-hero까지
스칼라 단위 역전파 엔진 micrograd와 신경망 기초부터 GPT 구현까지 다루는 nn-zero-to-hero 강의 리포지토리를 단계별로 학습할 수 있는 오픈소스 개발 가이드입니다.
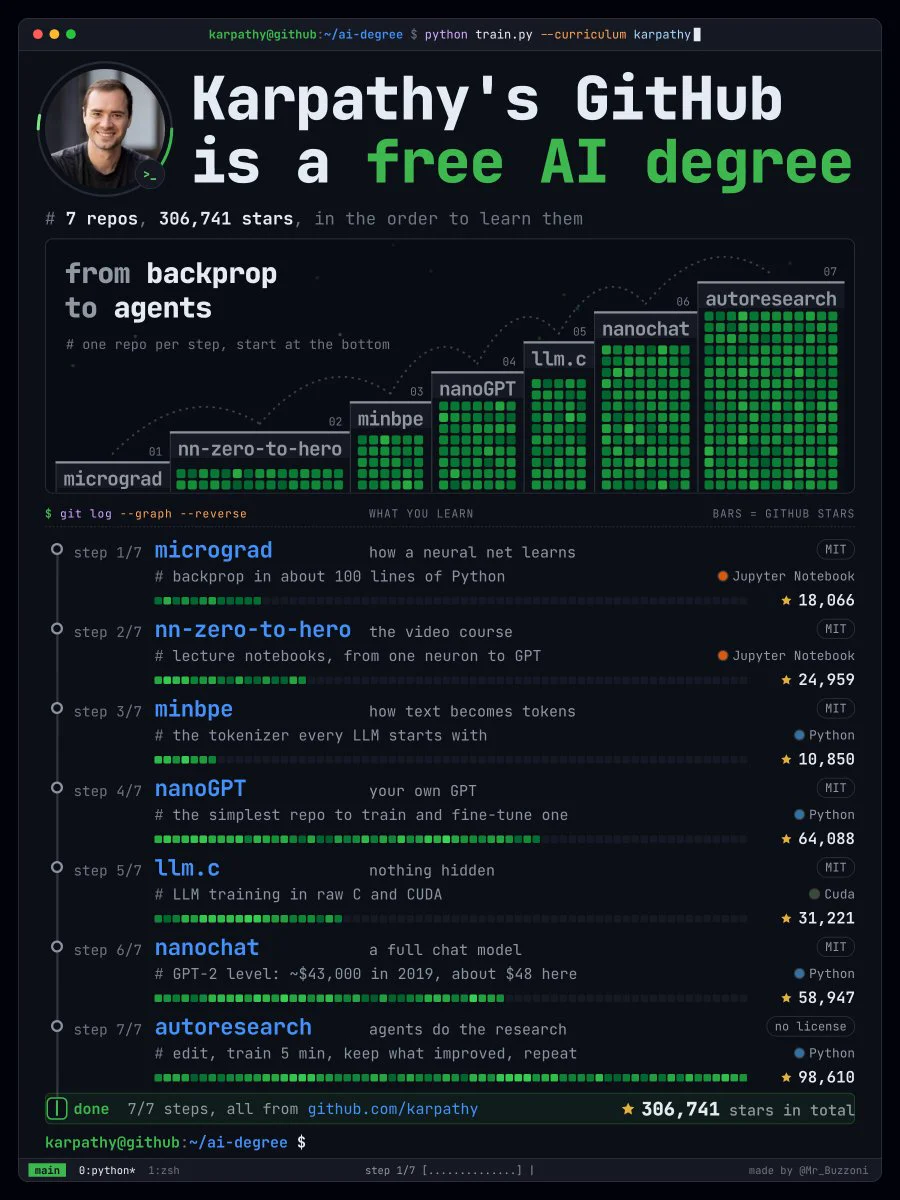
머신러닝 프레임워크가 고도화되면서 대부분의 엔지니어는 텐서 연산과 역전파 과정을 추상화된 고수준 API로 처리합니다. 안드레이 카파시(Andrej Karpathy)가 공개한 micrograd와 nn-zero-to-hero 리포지토리는 이러한 고수준 추상화를 걷어내고 신경망 내부의 연산 그래프와 그래디언트 흐름을 밑바닥부터 파악하도록 돕는 오픈소스 학습 프로젝트입니다.
이미지 출처: https://x.com/F5Adon/status/2116475548549669005
2020년 처음 공개된 micrograd와 2022년부터 이어진 nn-zero-to-hero는 단일 스칼라 연산 그래프부터 출발해 최신 GPT 아키텍처와 토크나이저까지 단계적으로 확장되는 체계적인 커리큘럼을 제공합니다. 두 리포지토리 모두 MIT 라이선스로 배포되어 누구나 코드를 분석하고 자유롭게 수정할 수 있습니다.
스칼라 기반 autograd 엔진 micrograd의 구조와 동작
karpathy/micrograd의 핵심은 약 100라인의 스칼라 기반 자동 미분(autograd) 엔진과 그 위에 얹은 약 50라인의 경량 신경망 라이브러리입니다.
PyTorch와 유사한 API 스타일을 유지하면서도 다차원 텐서 대신 스칼라(Scalar) 값 단위로 연산 그래프(동적 DAG)를 구성합니다. 뉴런 하나에서 일어나는 덧셈과 곱셈, 활성화 함수(ReLU) 계산을 개별 노드로 쪼개어 정방향 계산(Forward pass)을 수행하고, 각 노드의 미분값을 체인 룰(Chain rule)을 통해 역방향(Backward pass)으로 전파합니다.
리포지토리는 pip 패키지로 간편하게 설치해 실습할 수 있습니다.
pip install micrograd
기본 패키지에 포함된 demo.ipynb 노트북에서는 micrograd.nn 모듈을 사용해 16개 노드를 가진 은닉층 2개 구조의 다층 퍼셉트론(MLP)을 구성하고, SVM 마진 손실 함수와 SGD(확률적 경사 하강법)를 적용해 초승달 형태의 문(moon) 데이터셋에 대한 2진 분류 결정 경계를 직접 학습시키는 과정을 확인할 수 있습니다.
또한 trace_graph.ipynb 노트북을 활용하면 Graphviz를 통해 각 연산 노드의 순전파 데이터값과 역전파로 계산된 그래디언트 수치를 시각화된 그래프로 추적할 수 있습니다. 자동 미분 엔진의 수학적 정확성을 검증하기 위해 PyTorch를 레퍼런스로 활용하는 단위 테스트 환경(python -m pytest)도 기본 제공됩니다.
'Zero to Hero' 커리큘럼: 신경망 기초부터 GPT 구현까지
karpathy/nn-zero-to-hero는 카파시가 진행한 유튜브 강의 영상과 직접 연동되는 Jupyter 노트북 코드베이스(lectures/ 디렉터리)를 모아둔 리포지토리입니다.
이 과정은 micrograd를 직접 손으로 구현해보는 첫 강의를 시작으로 언어 모델링의 기초부터 최신 트랜스포머 모델까지 점진적으로 난도를 높입니다.
- micrograd 구현 (Lecture 1): 신경망 역전파와 경사 하강법의 원리를 스칼라 레벨에서 직접 코딩합니다.
- makemore 시리즈 (Lecture 2~6): 문자 단위 바이그램(Bigram) 모델에서 시작해 다층 퍼셉트론(MLP), 배치 정규화(BatchNorm)와 활성화 함수 통계 분석, 수동 역전파 계산, 그리고 WaveNet 구조의 합성곱 신경망(CNN)까지 확장합니다.
- GPT 밑바닥 구현 (Lecture 7): 'Attention is All You Need' 논문과 OpenAI의 GPT-2/GPT-3 구조를 바탕으로 자체 어텐션(Self-Attention) 메커니즘과 트랜스포머 언어 모델을 순수 코드로 작성합니다.
- GPT 토크나이저 구현 (Lecture 8): 텍스트를 토큰으로 변환하는 Byte Pair Encoding(BPE) 알고리즘을 다루는
minBPE리포지토리를 통해 LLM 파이프라인의 전처리 단계를 구현합니다.
각 강의 노트북은 복잡한 서드파티 라이브러리의 마법 같은 함수에 기대지 않고, 원시 텐서 연산과 인덱싱, 행렬 곱셈을 명시적으로 작성하도록 구성되어 있습니다.
학습 시 유의할 점과 실무 관점의 한계
이들 리포지토리는 딥러닝 내부 메커니즘에 대한 직관을 형성하는 데 최적화된 교육용 도구입니다.
다만 micrograd는 스칼라 단위 연산을 파이썬 객체로 추적하므로 대규모 행렬 연산 최적화나 GPU 가속이 배제되어 있습니다. 따라서 실제 상용 프로덕션 환경에서 대규모 파라미터를 갖춘 모델을 학습시키는 용도로는 적합하지 않습니다. 텐서 단위 벡터화 연산과 하드웨어 가속이 필요한 실무 단계에서는 PyTorch나 JAX 같은 완성형 프레임워크를 사용해야 합니다.
아울러 nn-zero-to-hero 커리큘럼의 후반부 예제 및 micrograd의 단위 테스트를 원활히 구동하려면 로컬 머신에 PyTorch 실행 환경이 사전 구성되어 있어야 합니다. 대형 프레임워크의 블랙박스 뒤편에서 일어나는 수치 미분과 텐서 흐름을 원리부터 검증하고자 하는 개발자에게 최적의 레퍼런스를 제공합니다.
출처
- GitHub 리포지토리: karpathy/micrograd
- GitHub 리포지토리: karpathy/nn-zero-to-hero