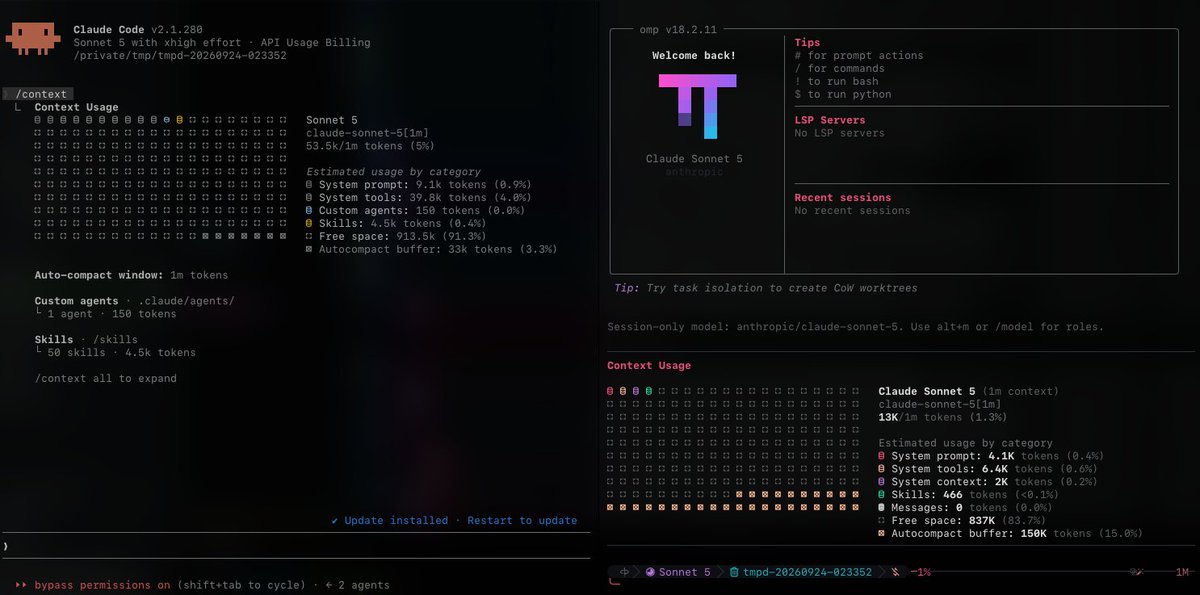
Compressing Base Context from 30k to 10k for Local LLM Prefill: Coding Harness 18.3.0 Optimization
Coding agent harness 18.3.0 slashes base prompt token usage from ~30k to 10k for faster local model prefill, consolidates tools into read/write/bash, enables de